
アクセスが重なったとき、DBに空き接続がなく、検索を始める前に待たされることがあります。接続プール(DBとの接続を用意し、使い回す仕組み)の上限を増やせば、この待ちを減らせそうです。
ただ、知りたいのは接続待ちが減るかだけではありません。検索結果が返るまでの時間も短くなるのか。 それを確かめるため、同じPostgresで接続数を5・20・100本に変え、接続を借りる前と借りた後の時間を分けて測りました。
実験では、10件の検索をまとめて送ると、5本の接続では接続を借りるまでに平均22.1ms待っていました。20本に増やすと、この待ちはほぼゼロになりました。ところが、接続の返却まで含めた処理全体の平均は、72.3msから95.7msへ長くなりました。
今回分かったのは、接続待ちが減っても、それだけでは処理全体の改善と判断できないことです。以下では、どの区間の時間が増えたのかを確かめ、自分のアプリでも接続数を変える前後で何を記録すればよいかを説明します。
CPUを0.5コアに制限した小さなDBに、決まった件数を送った実験です。どの環境でも使える最適な接続数や、最大処理能力を求めた結果ではありません。
接続を借りる前と、借りた後を分けて測る
検索などのクエリを実行する処理は、まずプールから接続を借り、使い終わったら返します。空きがなければ、借りるところで待つことになります。asyncpgの公式資料にも、この取得と返却の使い方が載っています。
今回はPythonのasyncpgを使い、プールの上限を5・20・100本にしました。各条件とも、その本数の接続を事前にすべて確立しています。リクエストごとに新しく接続する時間は、測定に含めていません。
DB側のmax_connectionsは全条件で110のままです。これはPostgresが受け入れる同時接続の上限で、今回変えたアプリ側のプール上限とは別の設定です。PostgreSQLの接続設定を参照してください。
開始まで送信側の遅れ
接続を借りる取得待ち
結果を受け取るクエリ往復
プールに返す返却処理
全体の時間は、送信予定時刻から、接続の返却が終わるまでとしました。接続を取得できた時刻と、SQLの結果を受け取った時刻も記録しています。返却処理には、asyncpgの標準の接続リセットも含まれます。
「クエリ往復」はクライアント側で測った経過時間です。DB内部の純粋なSQL実行時間ではありません。DB側の実行や待ち、クライアント側で結果を扱う処理などが含まれます。
取得待ちはほぼ消えたが、全体の平均は長くなった
10件ずつまとめて送る条件について、4つの区間の平均時間を並べました。全体も、それぞれの区間も、同じリクエストを対象とした平均です。
| 集中送信の平均時間 | 5接続 | 20接続 | 100接続 |
|---|---|---|---|
| 送信予定から開始まで | 1.7ms | 2.0ms | 2.2ms |
| プール取得待ち | 22.11ms | 0.03ms | 0.03ms |
| クエリ往復 | 38.4ms | 79.9ms | 80.3ms |
| プール返却 | 10.1ms | 13.8ms | 13.8ms |
| 全体 | 72.3ms | 95.7ms | 96.4ms |
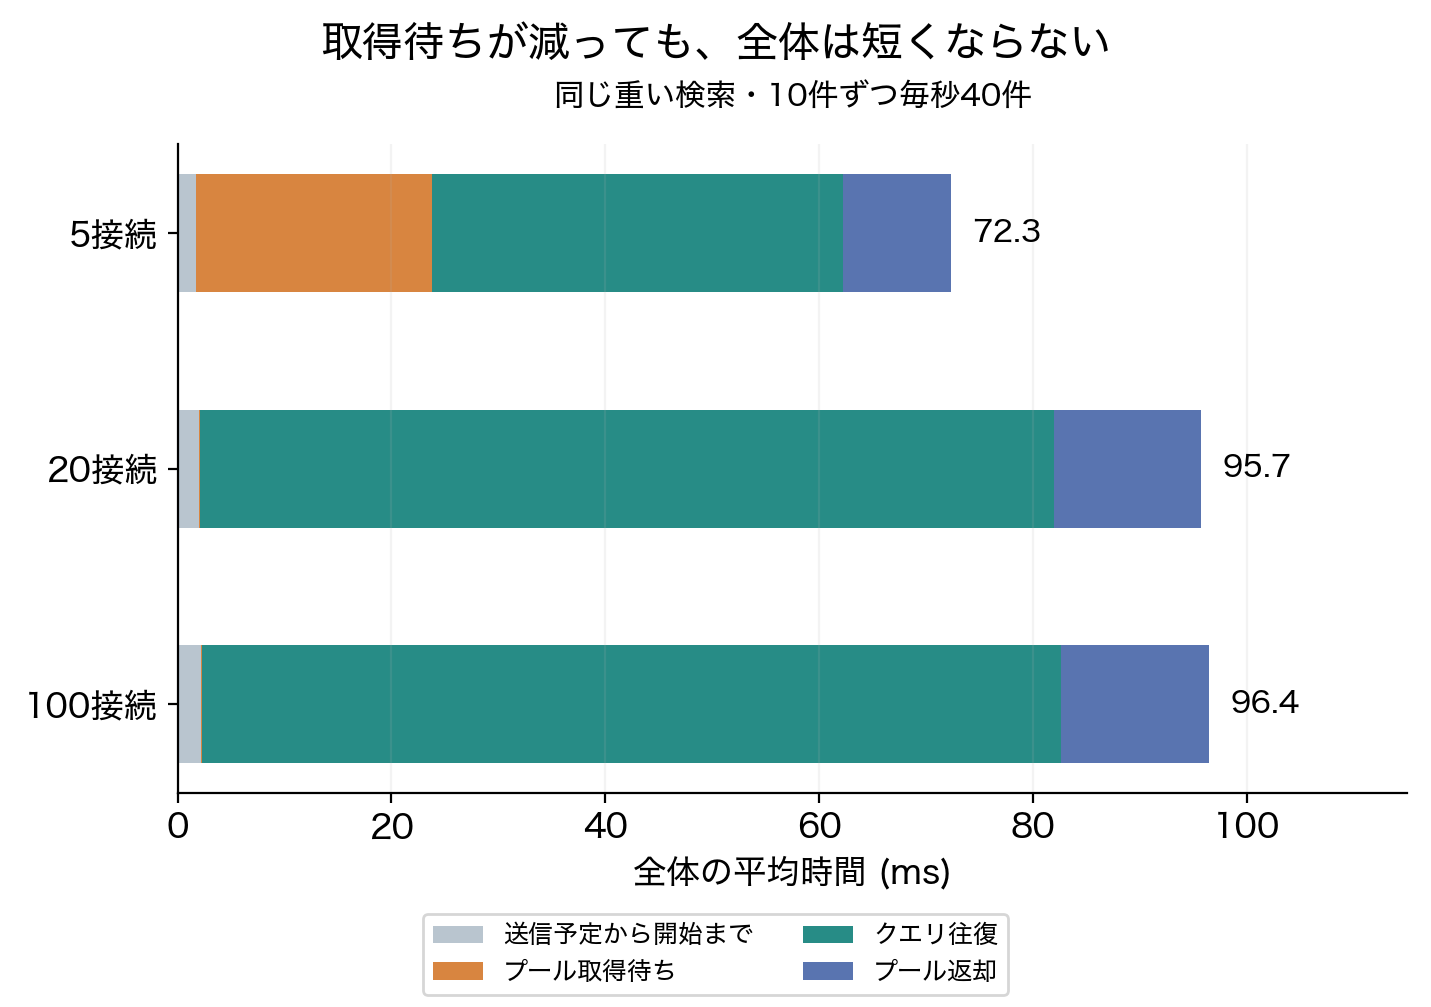
5接続では、同時に来る10件の一部が接続を借りる前に待ちます。20接続と100接続なら10件すべてが接続を借りられ、その待ちはほぼなくなりました。その一方で、クエリ往復の平均時間は約38msから約80msへ増えています。返却処理も含めると、全体の平均も長くなりました。
この測定から言えるのは、取得待ちの減少と、取得後の区間の増加が同時に観測されたことです。減った22msがそのまま別の場所へ移った、という足し引きではありません。また、クエリ往復のどの部分で何ms待ったかは、今回の記録だけでは分離できません。
接続数を増やせば、より多くの処理をDBへ送れます。ただし今回は、DBが使えるCPUの総量を増やしていません。先へ送れる件数と、実際に計算を進められる量は分けて考える必要があります。
同じDBに、3通りの負荷を送る
用意したデータは20,000行、テーブルとインデックスを合わせて約3.8MiBです。軽い検索は主キーで1行を取り出す処理、重い検索は2,000行の文字列にMD5計算を行って集約する処理にしました。「重い検索」は計算を伴う比較用の処理で、実サービスのクエリを再現したものではありません。
-- 軽い検索
SELECT balance FROM pool_lab WHERE id = $1;

-- 重い検索
SELECT sum(length(md5(payload || id::text)))
FROM pool_lab
WHERE id BETWEEN $1 AND $1 + 1999;
送信方法は次の3条件です。応答を待ってから次を送るのではなく、送信予定を先に決めておきます。
| 条件 | 送信予定 | 各プール条件の測定件数 |
|---|---|---|
| 軽い検索・均等送信 | 5msごとに1件、毎秒200件 | 7,200件 |
| 重い検索・均等送信 | 25msごとに1件、毎秒40件 | 1,440件 |
| 重い検索・まとめ送り | 250msごとに10件、毎秒40件 | 1,440件 |
重い検索の2条件は、SQLも平均の送信件数も同じです。変えたのは、短い時間に集中させるかどうか。軽い検索と重い検索は送信件数が異なるため、両者を使ってクエリの性能倍率を計算しません。
CPU上限はDB全体で0.5コア、負荷生成側も別に0.5コアとしました。制限周期は10msです。各接続で事前にSQLを実行した後、2秒のウォームアップを行い、12秒ずつ3回測定しました。プールの実施順序を入れ替えた合計27回、30,240件すべてが完了しています。
遅い応答や、アクセスが集中したときも比べる
平均だけでは、一部の応答が遅れる様子をつかみにくいことがあります。そこで、遅い側の応答時間も比べました。例えば100件を速い順に並べたときの99番目に当たる時間です。以下の表では、各条件の3回分をまとめて求めています。先ほどの平均時間とは別の見方です。
| 送信条件 | 5接続 | 20接続 | 100接続 |
|---|---|---|---|
| 軽い検索・均等200件/秒 | 1.90ms | 1.88ms | 1.94ms |
| 重い検索・均等40件/秒 | 11.22ms | 14.69ms | 13.63ms |
| 重い検索・10件ずつ40件/秒 | 125.98ms | 133.19ms | 132.09ms |
軽い検索では、接続数を変えても遅い側の応答時間は約1.9msでした。重い検索を均等に送った場合も、接続数を増やすほど短くなる関係は見られません。
差が大きかったのは、同じ毎秒40件をどう送るかでした。10件ずつまとめると、遅い側の応答時間は約126〜133msになっています。
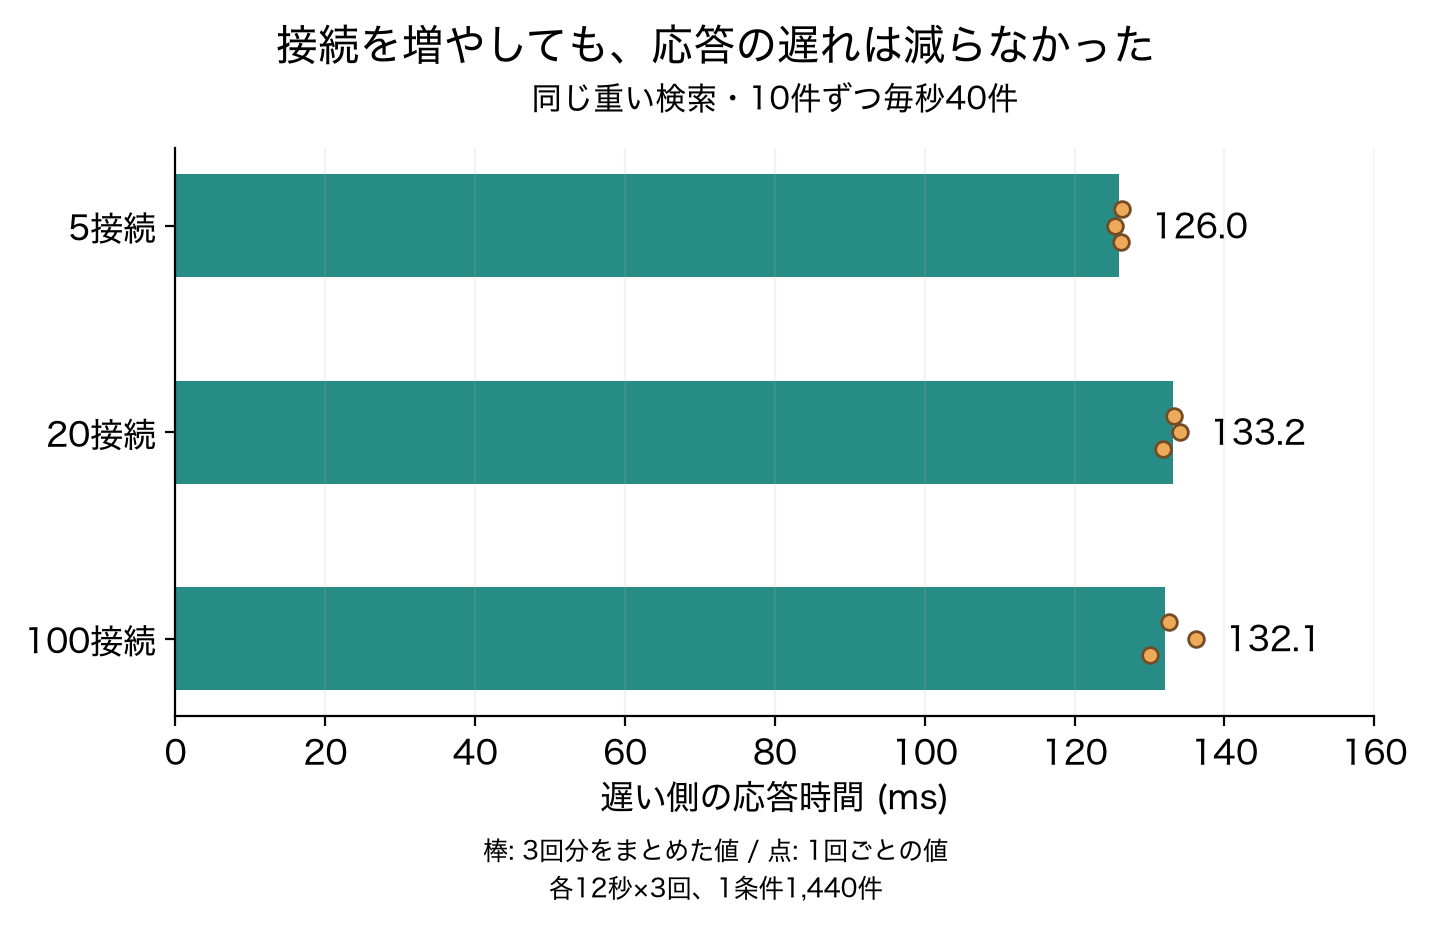
各回に同じ方法で求めた値にも幅があります。集中送信は、5接続で125.3〜126.3ms、20接続で131.8〜134.0ms、100接続で130.0〜136.2msでした。3回の最小・最大であり、信頼区間ではありません。細かな差を一般的な優劣と捉えず、この条件では接続数を増やしても改善しなかった、と読みます。
完了件数は、軽い検索が約200件/秒、重い検索はどちらの送信方法でも約40件/秒です。これは指定した件数を処理できたという結果です。送信量を増やして限界を探してはいないので、「どのプールでも最大40件/秒」という意味ではありません。
平均CPUに余裕があっても、短い集中では制限がかかる
今回はLinuxのcgroupで、DBの全プロセスを合わせて、10msの周期に使えるCPU時間を5msに制限しています。複数の処理を同時に進めても、グループ全体の予算が増えるわけではありません。設定とカウンターの意味はLinuxカーネルの公式資料で確認できます。
集中送信のDB平均CPU使用量は、5接続で0.247コア、20接続で0.260コア、100接続で0.265コアでした。設定上限0.5コアに対して約49〜53%です。
それでも、CPU制限は発生していました。cpu.statが記録した制御周期数(nr_periods)に対する、制限がかかった周期数(nr_throttled)の割合は、集中送信で約84〜85%でした。各カウンターの測定前後の増分から計算した値です。測定時間全体に対する割合や、待っていた時間の割合ではありません。 カウンターの定義はカーネル公式資料の統計の説明も参照してください。長い測定区間の平均と、短い制限周期の中で起きることは同じではありません。
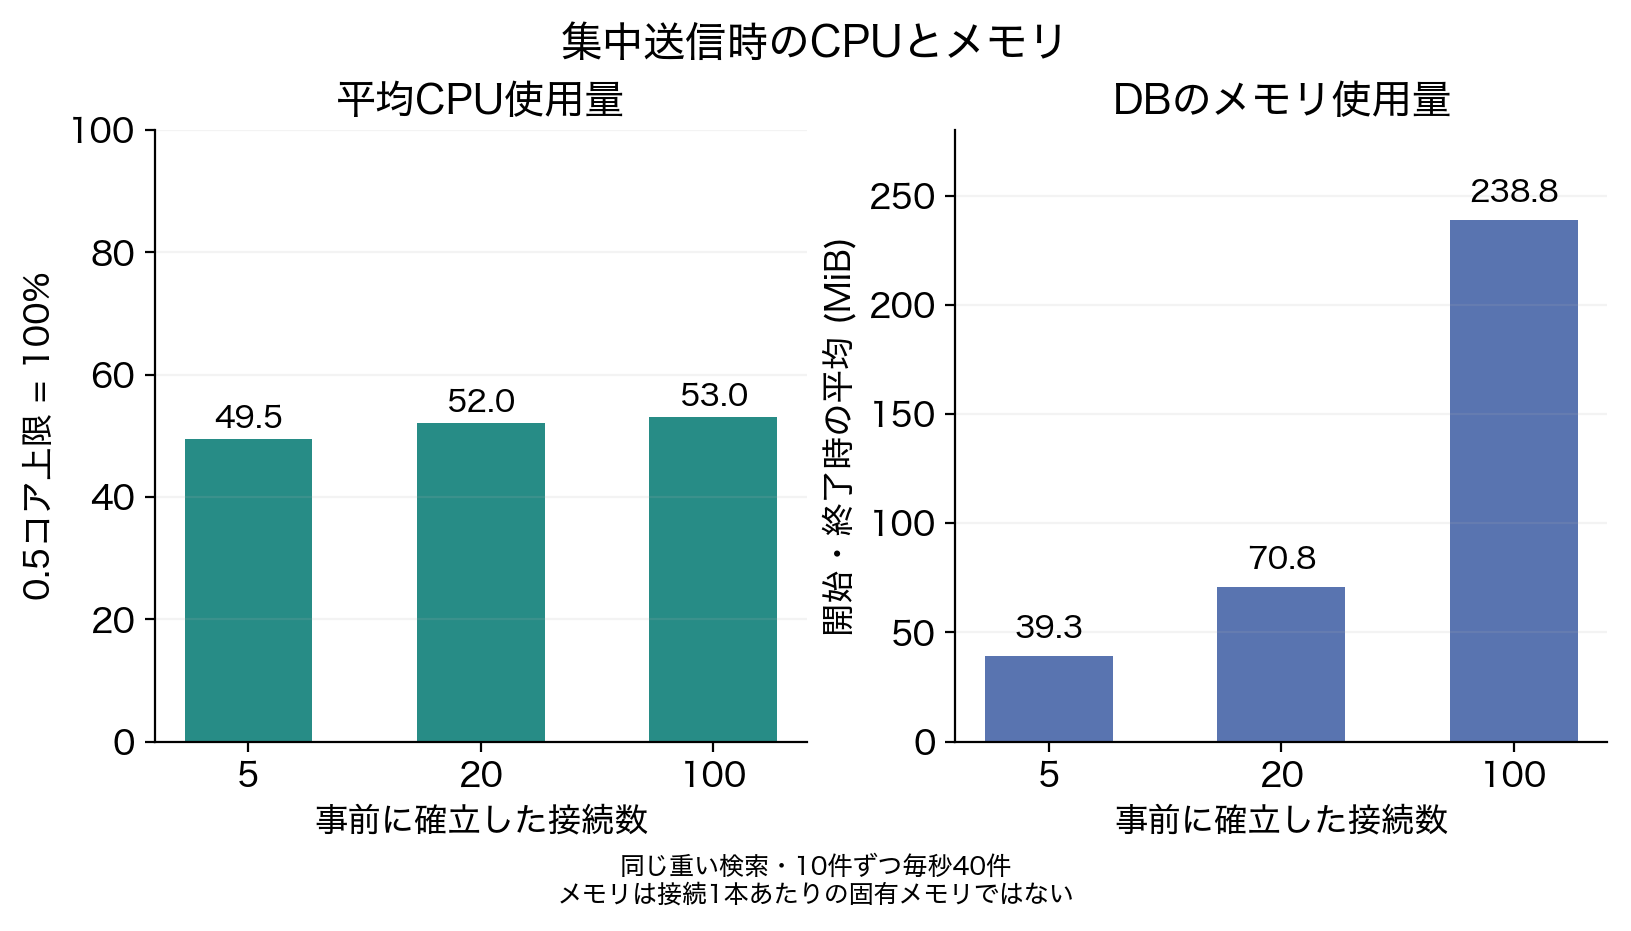
CPU制限は、取得後の時間を考える手がかりになります。ただし、CPU上限を外した対照実験はしていません。制限された周期数から、1リクエストの待ち時間を直接求めることもできません。今回の遅延をすべてCPU制限だけの影響とは断定しません。
もう1つ変わったのがメモリです。集中送信では、DBのcgroup使用量が約39MiBから約239MiBへ増えました。今回はプール上限と同じ数の接続をすべて事前に確立しています。実アプリで上限だけを100にし、実際には少数しか接続しない場合に、同じ増え方をするという結果ではありません。
実験条件・集計・再開した測定について
実行環境はRaspberry Pi 5、Linux/aarch64、4論理CPU、PostgreSQL 16.13、Python 3.11.2、asyncpg 0.31.0です。同一マシン内のUnixソケットで接続し、他の処理が動くホストを使用しています。
DBのメモリ上限は768MiB、shared_buffersは64MiB、work_memは1MiB。JITと並列クエリは無効です。小さなデータをウォームアップした読み取り専用の実験なので、書き込み、ロック競合、ディスクI/O、ネットワーク越しのDBの傾向は判断できません。
プールはmin_size=0で作り、5・20・100本を順番に取得して全数を確立し、事前実行後に返却します。アイドル接続のタイムアウトは無効にしてあり、測定前の実接続数が指定本数であることも確認しています。
送信予定の遅れも全体時間に含めました。この開始の遅れを短い順に並べ、本文と同じ方法で求めた値は、均等送信で約1.3〜2.1ms、集中送信で約6.1〜7.3msです。遅い側の応答時間は各条件の全測定値を昇順に並べ、ceil(件数×0.99)番目を採用しています。CPUはusage_usecの増分を観測秒数で割り、条件内の各回を観測秒数で重み付けして集計しました。
測定は安全監視による中断を挟む2つのブロックに分かれています。11回の完了後にホスト負荷の基準を超えたため停止し、残り16回は同じ設定・データの一時DBを作り直して行いました。再開時には測定後の接続切断を順番に行うようにしました。測定中のSQL、送信予定、資源上限、ウォームアップは変えていません。厳密な連続実験ではない点も、比較の制約です。
それ以前の100ワーカーで行った予備試行は、安全停止後に方式を変更しており、この記事の集計には含めていません。測定後の一時DB・サービス・ファイルの削除と、残留がないことを確認しています。
測定データ
条件別の集約値、27回それぞれの値、30,240件の測定値、測定項目と集計方法を添付します。内部の監視記録は含めていません。
結論:接続待ちを減らせたかと、全体が速くなったかを一緒に確かめる
最初の疑問は、DBの接続待ちを減らすためにプールを増やせば、処理全体も速くなるのか、でした。今回の条件では、接続待ちはほぼなくなった一方で、クエリを送って結果を受け取る区間が長くなり、全体は速くなりませんでした。
自分のアプリで接続待ちを見つけたときは、次の順番で確かめられます。
- 設定を変える前に、処理全体とDB呼び出しの時間を記録する。 Webアプリなら、まずAPIや画面の応答が返るまでの時間を記録します。DBを呼ぶ部分では、接続を借りる直前、借りた直後、SQLの結果を受け取った直後、接続を返し終わった直後の4つの時刻を残します。隣り合う時刻の差から、「接続待ち」「SQLを送って結果を受け取る時間」「返却処理」を求められます。
- 接続数だけを変え、同じ項目を記録して比べる。 SQLや送信件数に加え、アクセスが来る間隔も揃えます。接続待ちだけでなく、処理全体の応答と、取得後の各区間がどう変わったかを確認します。
- 接続待ちが減っても全体が速くならなければ、さらに増やす前に取得後を調べる。 SQLを送ってから結果が返るまでの時間、DBのCPU使用量とCPU制限、接続の返却処理を確認します。今回も、取得待ちだけを見ていたら、約38msから約80msへ増えたクエリ往復の時間を見落としていました。
接続を増やして全体も速くなった場合は、そのアクセス条件では効果があったと判断できます。その際も、DBのメモリ使用量やCPUの変化を一緒に確認します。今回のように接続をすべて事前に確立する条件では、接続数を増やすとメモリ使用量も増えていました。
なお、今回まとめて送ったのは最大10件です。20接続でも100接続でも、その10件が同時に接続を借りられます。100件が同時に来る場合や、ネットワーク待ちの長い処理を確かめた結果ではありません。
接続数を何本にするかを、この実験だけで決めることはできません。接続待ちを減らすために設定を変えたなら、利用者が待つ全体の時間も短くなったかを確認する。改善したかどうかを決めるのは、その両方を比べた後です。
Webアプリの公開に
GitHubに置いたWebアプリを、日本リージョンで動かしたい方へ。KamuiDashでは、リポジトリからアプリをデプロイできます。