
請求同時到達時,可能因為沒有可用的資料庫連線,在查詢開始之前就必須等待。增加連線池(預先保留並重複使用資料庫連線的機制)的上限,看起來可以減少這段等待。
但我們想知道的不只是連線等待會不會減少。收到查詢結果之前的時間,也會縮短嗎? 為了確認這件事,我們在同一個Postgres把連線數改為5、20、100條,分開量測借到連線之前與之後的時間。
實驗中,每批送出10次查詢時,5條連線的借用等待平均為22.1ms。增加到20條後,這段等待幾乎消失。但包含歸還連線的整體平均時間,卻從72.3ms增加到95.7ms。
這次條件下,連線等待減少,不能單獨作為整體處理改善的判斷。以下會確認增加的時間落在哪些區間,並說明自己的應用程式在改變連線數前後,可以記錄哪些項目。
這是對CPU限制為0.5核心的小型資料庫,發送固定請求數的實驗。它無法找出適用於所有環境的最佳連線數,也不是最大處理能力的量測。
分開量測借到連線之前與之後的時間
執行搜尋等查詢的工作會先借用連線,用完後再歸還。如果沒有可用連線,就必須在借用時等待。asyncpg官方文件也示範了取得與歸還的用法。
我們使用Python的asyncpg,把連線池上限設為5、20、100條。每個條件都事先建立了指定數量的全部連線。量測不包含每次請求重新建立連線的時間。
資料庫端的max_connections在所有條件下都維持110。它是Postgres可接受的同時連線數上限,與這次調整的應用程式端連線池上限不同。可參考PostgreSQL連線設定。
工作開始發送端延遲
借用連線取得等待
並收到結果查詢往返
歸還連線池歸還處理
整體時間定義為從預定發送時刻,到連線歸還完成為止。我們也記錄取得連線及收到SQL結果的時刻。歸還處理包含asyncpg標準的連線重設。
「查詢往返」是從用戶端量到的經過時間,並非資料庫內部純粹的SQL執行時間。它包含資料庫端的執行與等待,以及用戶端處理結果的時間等。
取得等待幾乎消失,整體平均卻變長了
下表列出每批10次條件的4個區間平均時間。整體與各區間,都是對相同請求求出的平均。
| 集中發送的平均時間 | 5條連線 | 20條連線 | 100條連線 |
|---|---|---|---|
| 預定發送至工作開始 | 1.7ms | 2.0ms | 2.2ms |
| 連線池取得等待 | 22.11ms | 0.03ms | 0.03ms |
| 查詢往返 | 38.4ms | 79.9ms | 80.3ms |
| 歸還連線 | 10.1ms | 13.8ms | 13.8ms |
| 整體 | 72.3ms | 95.7ms | 96.4ms |
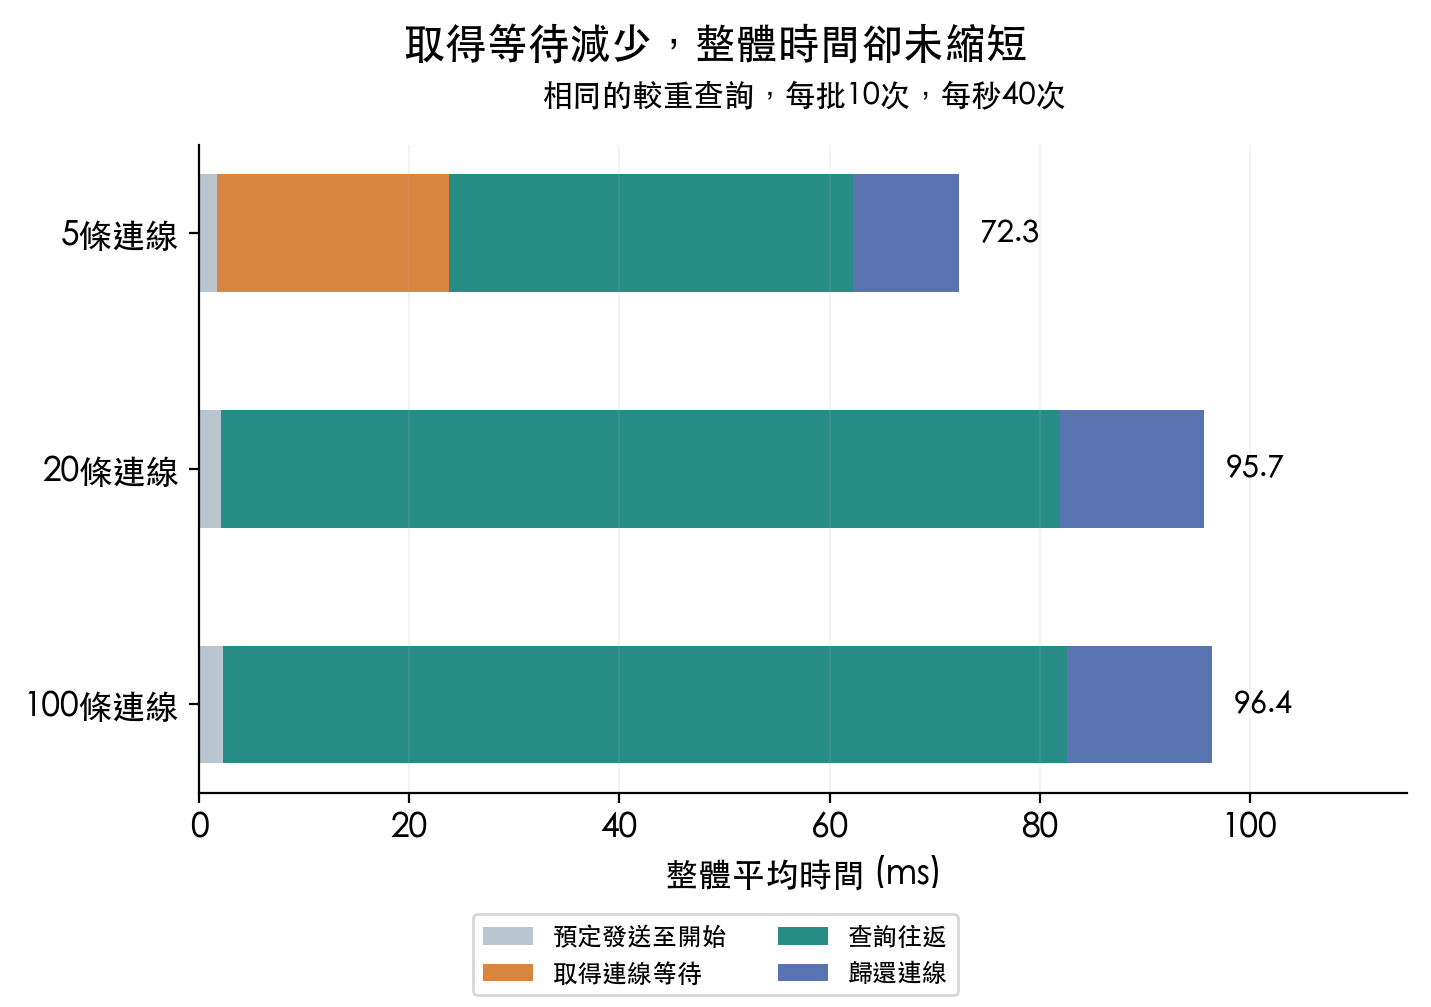
只有5條連線時,同時到達的10個請求中,有一部分會在借到連線之前等待。20條與100條都能讓10個請求取得連線,這段等待幾乎消失。另一方面,查詢往返的平均時間卻從約38ms增加到約80ms。加上歸還處理後,整體平均時間也變長了。
這次量測能說明的是,取得等待減少與取得後的區間增加,同時被觀察到。並不代表省下的22ms原封不動地移到了別處。僅憑這次記錄,也無法分離查詢往返的各部分究竟等待了多少毫秒。
增加連線,能讓更多工作送進資料庫。但這次沒有增加資料庫可用的CPU總量。能夠往前送的請求數,與實際能推進的計算量,需要分開考慮。
對同一個資料庫發送3種負載
資料共有20,000列,資料表與索引合計約3.8MiB。輕量查詢透過主鍵取出1列;較重的查詢則對2,000列字串計算MD5後彙總。「較重」是指用於比較、包含計算的工作,並非重現正式服務的查詢。
-- 輕量查詢
SELECT balance FROM pool_lab WHERE id = $1;

-- 較重的查詢
SELECT sum(length(md5(payload || id::text)))
FROM pool_lab
WHERE id BETWEEN $1 AND $1 + 1999;
發送方式有以下3種。預先決定發送時刻,不會等上一個回應完成後才送出下一個請求。
| 條件 | 預定發送方式 | 每個連線池設定的量測筆數 |
|---|---|---|
| 輕量查詢、均勻發送 | 每5ms發送1次,每秒200次 | 7,200 |
| 較重查詢、均勻發送 | 每25ms發送1次,每秒40次 | 1,440 |
| 較重查詢、集中發送 | 每250ms發送10次,每秒40次 | 1,440 |
兩個較重查詢條件使用相同SQL,平均發送率也相同。改變的是是否集中在短時間內發送。輕量與較重查詢的發送率不同,因此不以兩者計算查詢效能的倍率。
資料庫所有程序合計的CPU上限為0.5核心,負載產生端也另設0.5核心上限。限額週期為10ms。事先在每條連線上執行SQL後,暖機2秒,每個條件量測12秒、重複3次。調換連線池設定的執行順序,共27次量測,全部30,240個請求都已完成。
也比較較慢的回應與流量集中的情況
只看平均,可能不容易掌握部分回應延遲的情況。因此也比較較慢一側的回應時間。例如將100個回應由快到慢排列,取第99個回應的時間。下表合併各條件的3次量測計算,與前面的平均時間是不同的觀察方式。
| 發送條件 | 5條連線 | 20條連線 | 100條連線 |
|---|---|---|---|
| 輕量、均勻每秒200次 | 1.90ms | 1.88ms | 1.94ms |
| 較重、均勻每秒40次 | 11.22ms | 14.69ms | 13.63ms |
| 較重、每批10次、每秒40次 | 125.98ms | 133.19ms | 132.09ms |
輕量查詢不論連線數如何變動,較慢一側的回應時間都約為1.9ms。較重查詢均勻發送時,也沒有呈現連線越多就越快的關係。
差異更大的是相同每秒40次請求的發送方式。每批10次集中發送時,較慢一側的回應時間約為126~133ms。
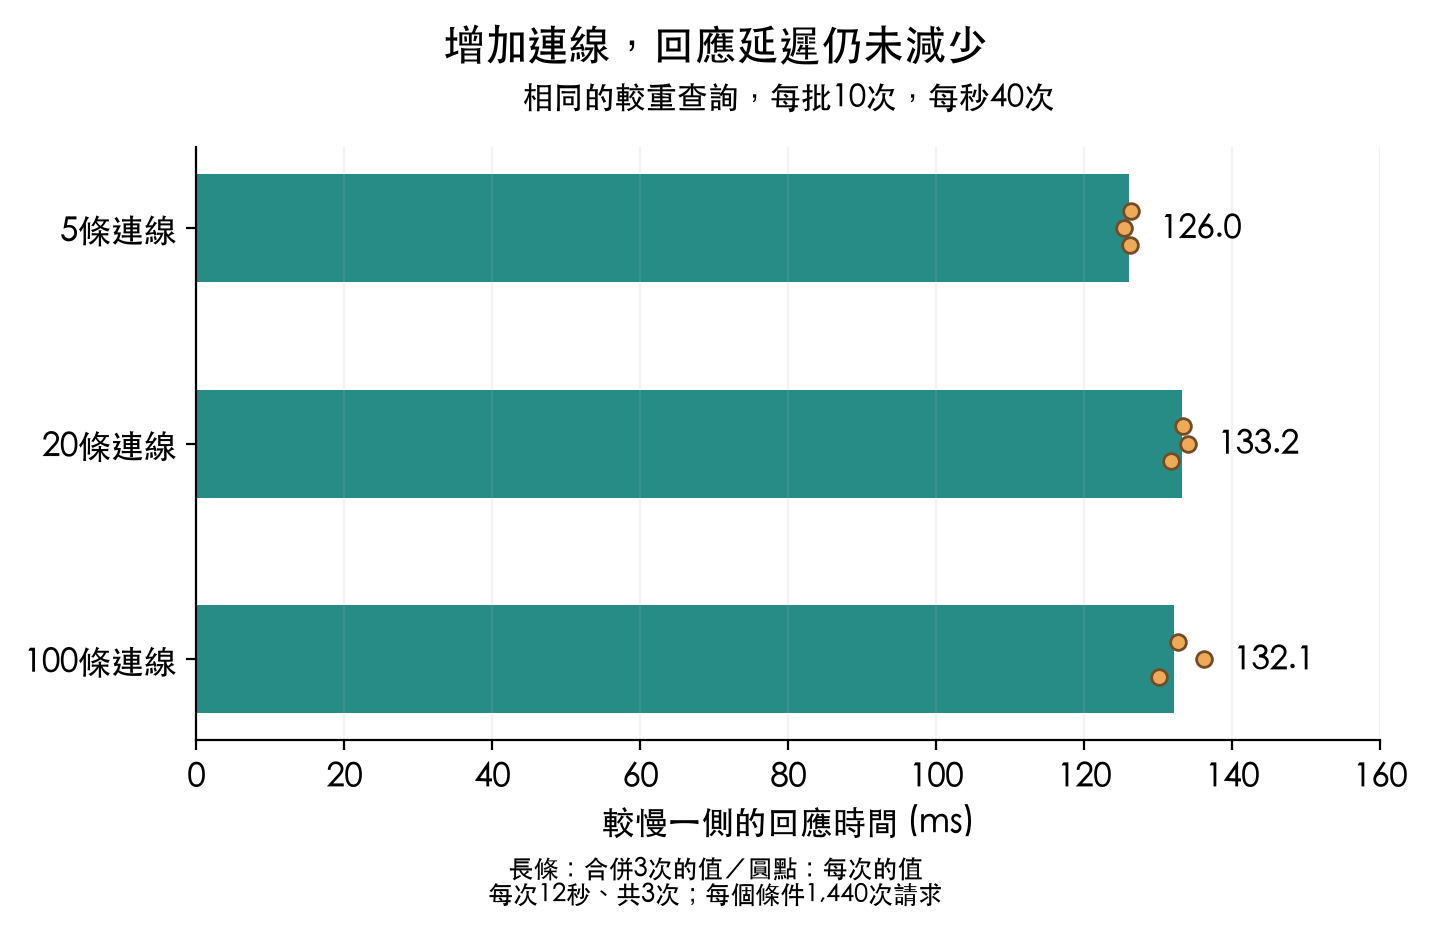
每次以相同方法求出的值也有變動。集中發送時,5條連線為125.3~126.3ms,20條為131.8~134.0ms,100條為130.0~136.2ms。這是3次量測的最小值與最大值,並非信賴區間。不把細小差異解讀為普遍的優劣,而是理解為:在這些條件下,增加連線沒有帶來改善。
完成速率方面,輕量查詢約為每秒200次;較重查詢無論哪種發送方式,都約為每秒40次。這代表指定的請求數能被處理。我們沒有提高發送率來尋找極限,因此不代表「所有連線池最多只能處理每秒40次」。
平均CPU有餘裕,短暫集中仍可能觸發限制
這次透過Linux cgroup,讓資料庫全部程序合計在每10ms週期內,最多使用5ms的CPU時間。同時執行多個工作,並不會增加整個群組的預算。設定與計數器的意義可參考Linux核心官方文件。
集中發送時,資料庫平均CPU用量在5條連線時為0.247核心,20條為0.260核心,100條為0.265核心。相對設定的0.5核心上限,約為49~53%。
即使如此,CPU限制仍然發生了。cpu.stat記錄的限額週期數(nr_periods)中,觸發限制的週期數(nr_throttled)約占84~85%。這是用量測前後各計數器的增量計算的。它不是量測總時間的比例,也不是等待時間的比例。 計數器的定義也可參考核心文件的統計說明。長時間區間的平均,與短週期內發生的事並不相同。
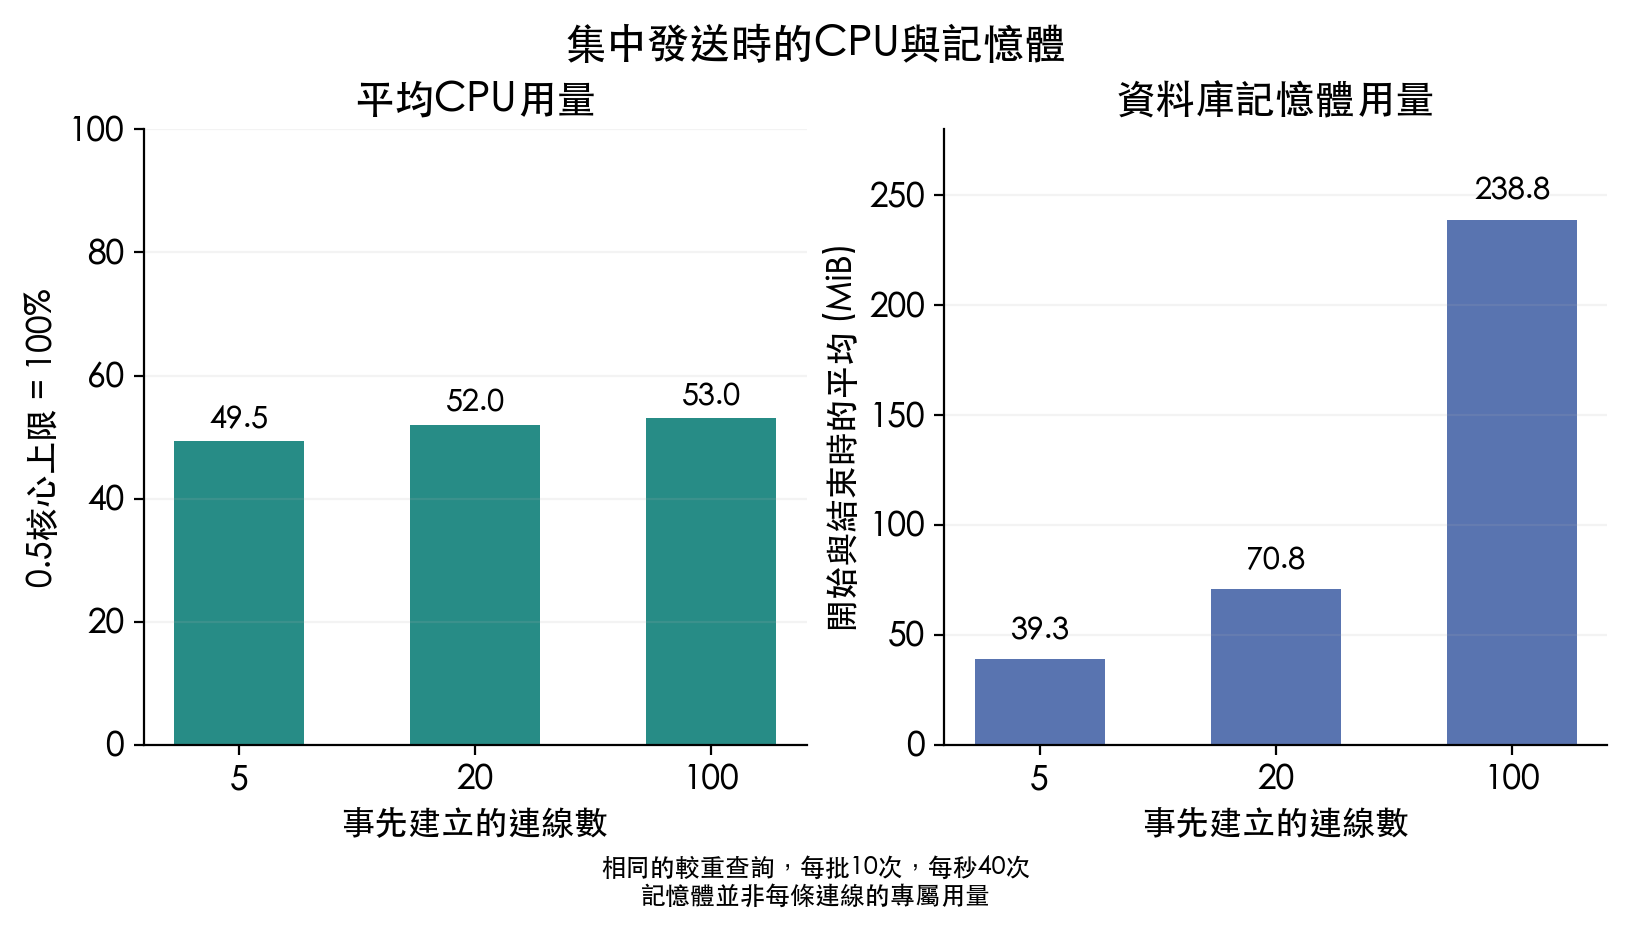
CPU限額是調查取得連線後時間的線索。但我們沒有做移除CPU上限的對照實驗,也無法由受限週期數直接算出單一請求的等待時間。因此,不把這次的延遲全部歸因於CPU限制。
另一個變化是記憶體。集中發送時,資料庫cgroup用量從約39MiB增加到約239MiB。這次事先建立了與連線池上限相同數量的全部連線。實際應用程式若只把上限設為100、實際卻使用少量連線,不能據此認定也會有相同增幅。
實驗條件、彙總與恢復量測的說明
執行環境為Raspberry Pi 5、Linux/aarch64、4個邏輯CPU、PostgreSQL 16.13、Python 3.11.2、asyncpg 0.31.0。透過同一台機器內的Unix socket連線,主機也執行其他工作。
資料庫記憶體上限為768MiB,shared_buffers為64MiB,work_mem為1MiB。停用JIT與平行查詢。這是小型資料暖機後的唯讀實驗,無法據此判斷寫入、鎖競爭、磁碟I/O或跨網路資料庫的趨勢。
連線池以min_size=0建立,依序取得連線直到5、20或100條全部建立,事先執行SQL後歸還。停用閒置連線逾時,並確認量測前的實際連線數符合指定值。
整體時間也包含從預定發送到實際開始工作的延遲。將這段開始延遲由短到長排列,以本文相同方法求出的值,均勻發送約1.3~2.1ms,集中發送約6.1~7.3ms。較慢一側的回應時間,是把各條件全部量測值由小到大排列,取第ceil(筆數×0.99)個。CPU用量以usage_usec增量除以觀測秒數,再以觀測秒數為權重彙總各次量測。
量測分為兩個區塊,中間曾因安全監控而停止。完成11次後,主機負載超過安全門檻;其餘16次則重建相同設定與資料的臨時資料庫後執行。恢復時,將量測結束後的連線關閉改為依序進行。量測期間的SQL、發送排程、資源上限與暖機方式沒有改變。這不是嚴格連續的實驗,也是比較時的限制。
更早使用100個worker的預備試驗,在安全停止後改用了不同方式,不包含在本文彙總中。實驗後已刪除臨時資料庫、服務及檔案,並確認沒有殘留。
量測資料
附上各條件彙總值、全部27次量測、30,240筆請求記錄,以及欄位與彙總方式說明。不包含內部監控記錄。
結論:一起比較連線等待與整體時間
最初的問題是:為了減少資料庫連線等待而增加連線池,整體處理也會變快嗎?這次條件下,連線等待幾乎消失,但送出查詢到收到結果的區間變長,整體並沒有變快。
在自己的應用程式發現連線等待時,可以依照以下順序確認。
- 改變設定前,先記錄整體回應與資料庫呼叫的時間。 Web應用程式先記錄API或頁面回應所需的時間。資料庫呼叫則記錄4個時刻:要求借用連線前、借到連線後、收到SQL結果後,以及歸還連線完成後。相鄰時刻的差值,可以求出連線等待、查詢往返與歸還處理的時間。
- 只改變連線數,記錄相同項目後比較。 除了SQL與請求數,也要保持請求到達的間隔一致。不只看連線等待,也確認整體回應與取得連線後各區間的變化。
- 連線等待減少、整體卻沒有變快時,先調查取得連線後的處理,再考慮繼續增加。 確認送出SQL到收到結果的時間、資料庫CPU用量與CPU限額,以及歸還連線的處理。這次若只看取得等待,就會漏掉查詢往返從約38ms增加到約80ms的變化。
如果增加連線也讓整體變快,可以判斷對這次測試的流量模式有效。同時也確認資料庫記憶體與CPU的變化。這次事先建立全部連線的條件下,增加連線數也伴隨記憶體用量增加。
這次每批最多10個請求。20條與100條連線都能讓這10個請求同時借到連線。這不是驗證100個請求同時到達,或網路等待很長的情況。
不能只用這次實驗決定連線數。為了減少連線等待而改變設定後,也要確認使用者等待的整體時間是否縮短。比較這兩者之後,再判斷是否改善。
部署Web應用程式
若想在日本區域執行放在GitHub上的Web應用程式,KamuiDash可直接從儲存庫部署應用程式。