
ログを追加してAPIが遅くなったとき、ログの内容を作る処理が重いのか、書き出す際に待たされているのかで、見直す場所は変わります。
そこで、同じAPIでログの量・書き出し方・出力先の速さを変え、内容を作る時間と書き込みの待ち時間が、応答にどう影響するかを比べました。
読後には、自分のAPIで「ログを作るだけ」と「実際に書き出す場合」を比べ、遅くなる場所を絞る方法が分かります。書き込みを別処理へ移す場合も、応答時間だけでなく、未処理のログが残っていないかを確認する理由を説明します。
実験で確かめた、ログの書き込み待ち
小さなAPIを用意し、リクエストが来るたびに、動作の記録である「ログ」を1行書き出すようにしました。
出力先には実験用のプログラムを使い、ログを少し受け取るたびに待ち時間を入れました。ログを出すAPIに、出力先の処理が追いつかない状況を作るためです。すると、ログの書き込みが待たされ、APIの応答まで約3秒かかるケースが出ました。
このときのログは、JSONという形式で作った約16KB(16KiB)の長い文字列です。短いメッセージではなく、1行に多くのデータを詰めています。ログは1行でも、書き込む量と受け取る側の速さによって、APIを待たせることがありました。
ログの書き込みを、APIの応答処理から切り離す方法も試しました。応答は速くなりましたが、ログの読み取りは最後のAPI応答後も約2秒続きました。応答が速くなったことと、ログの処理が終わったことは別でした。
一方、128バイトの短いログを1行から10行へ増やしても、今回の条件では、応答が行数に比例して遅くなる結果にはなりませんでした。以下では、ログの内容を作る時間、書き込みで待つ時間、ログを読み終える時間を分けて比べます。
7種類のログ処理を、同じAPIで比べる
比較にはPython 3.11.2の標準ライブラリを使いました。asyncioの1つのイベントループで動くHTTP APIに、同じ小さなハッシュ計算をさせ、同じJSONレスポンスを返します。変えるのは次のログ処理だけです。
| 条件 | リクエストごとの処理 | 出力バイト数 |
|---|---|---|
| ログなし | ログを作らず、出さない | 0 |
| 短文1行 | 固定の短文を同期出力 | 128 |
| 短文10行 | 同じ短文を10回、同期出力 | 1,280 |
| JSON生成のみ | JSON文字列を作るが、出さない | 0 |
| 事前生成JSONを同期出力 | 起動時に作ったJSON文字列を出す | 16,384 |
| JSON生成+同期出力 | 毎回JSON文字列を作って出す | 16,384 |
| JSON生成+キュー出力 | 毎回JSON文字列を作り、出力を別スレッドへ渡す | 16,384 |
バイト数は改行を含みます。大きなJSONは、長いASCII文字列を主体とする固定の合成データです。実際のリクエスト全体を記録したものではなく、複雑なオブジェクトの走査やマスキングの負担も測っていません。
同期出力にはlogging.StreamHandler、キュー出力にはQueueHandlerとQueueListenerを使います。出力先は、プロセス間でバイト列を渡す専用のFIFOです。StreamHandlerの仕様に沿って書き込みとflushを行い、もう一方のプロセスが読み取ります。
読み取り側を「人工的な制限なし」と「上限256KiB/秒」の2通りにしました。実ディスクへの永続化や、外部のログサービスへの転送性能を測る実験ではありません。
- アプリの処理
- JSONを生成
- StreamHandler
書き込み・flush - API応答
FIFOに空きがなければ、書き込み中に待つ。flushが戻っても、読み取り側が全量を読み終えたとは限らない。
- アプリの処理
- JSONを生成
- QueueHandler
キューへ渡す - API応答
別スレッドのQueueListener → StreamHandler → FIFO → 読み取り側、と処理が続く。JSON生成やキューへの投入はAPI側に残る。
QueueHandlerの公式説明でも、ハンドラーの処理を別スレッドへ移せることが説明されています。今回も、JSON生成と呼び出し側でのログ整形・投入は残し、出力ハンドラーだけを後段へ移しました。
短いログでは小さな差、大きなJSONでは出力先の差
毎秒20件を50ms間隔で8秒間送り、1回160件を全件完了まで観測しました。7条件×2種類の読み取り先を3回ずつ、合計42回・6,720件です。HTTPエラー、ログ欠落、キューからの破棄はゼロでした。
応答の遅れを見るため、平均だけでなく、遅い側の応答時間も比べます。例えば100件を速い順に並べたときの99番目に当たる時間です。ここでは各条件3回の480件をまとめて求めています。計測の始点は送信予定時刻、終点はレスポンス本文の受信完了です。接続作成や、APIが詰まって待つ時間も含めます。
| 条件 | 速い読取先 | 遅い読取先 |
|---|---|---|
| ログなし | 3.54ms | 4.32ms |
| 短文1行 | 5.24ms | 3.83ms |
| 短文10行 | 4.35ms | 4.10ms |
| JSON生成のみ | 4.40ms | 4.51ms |
| 事前生成JSONを同期出力 | 5.22ms | 2,912ms |
| JSON生成+同期出力 | 4.42ms | 3,005ms |
| JSON生成+キュー出力 | 5.97ms | 4.86ms |
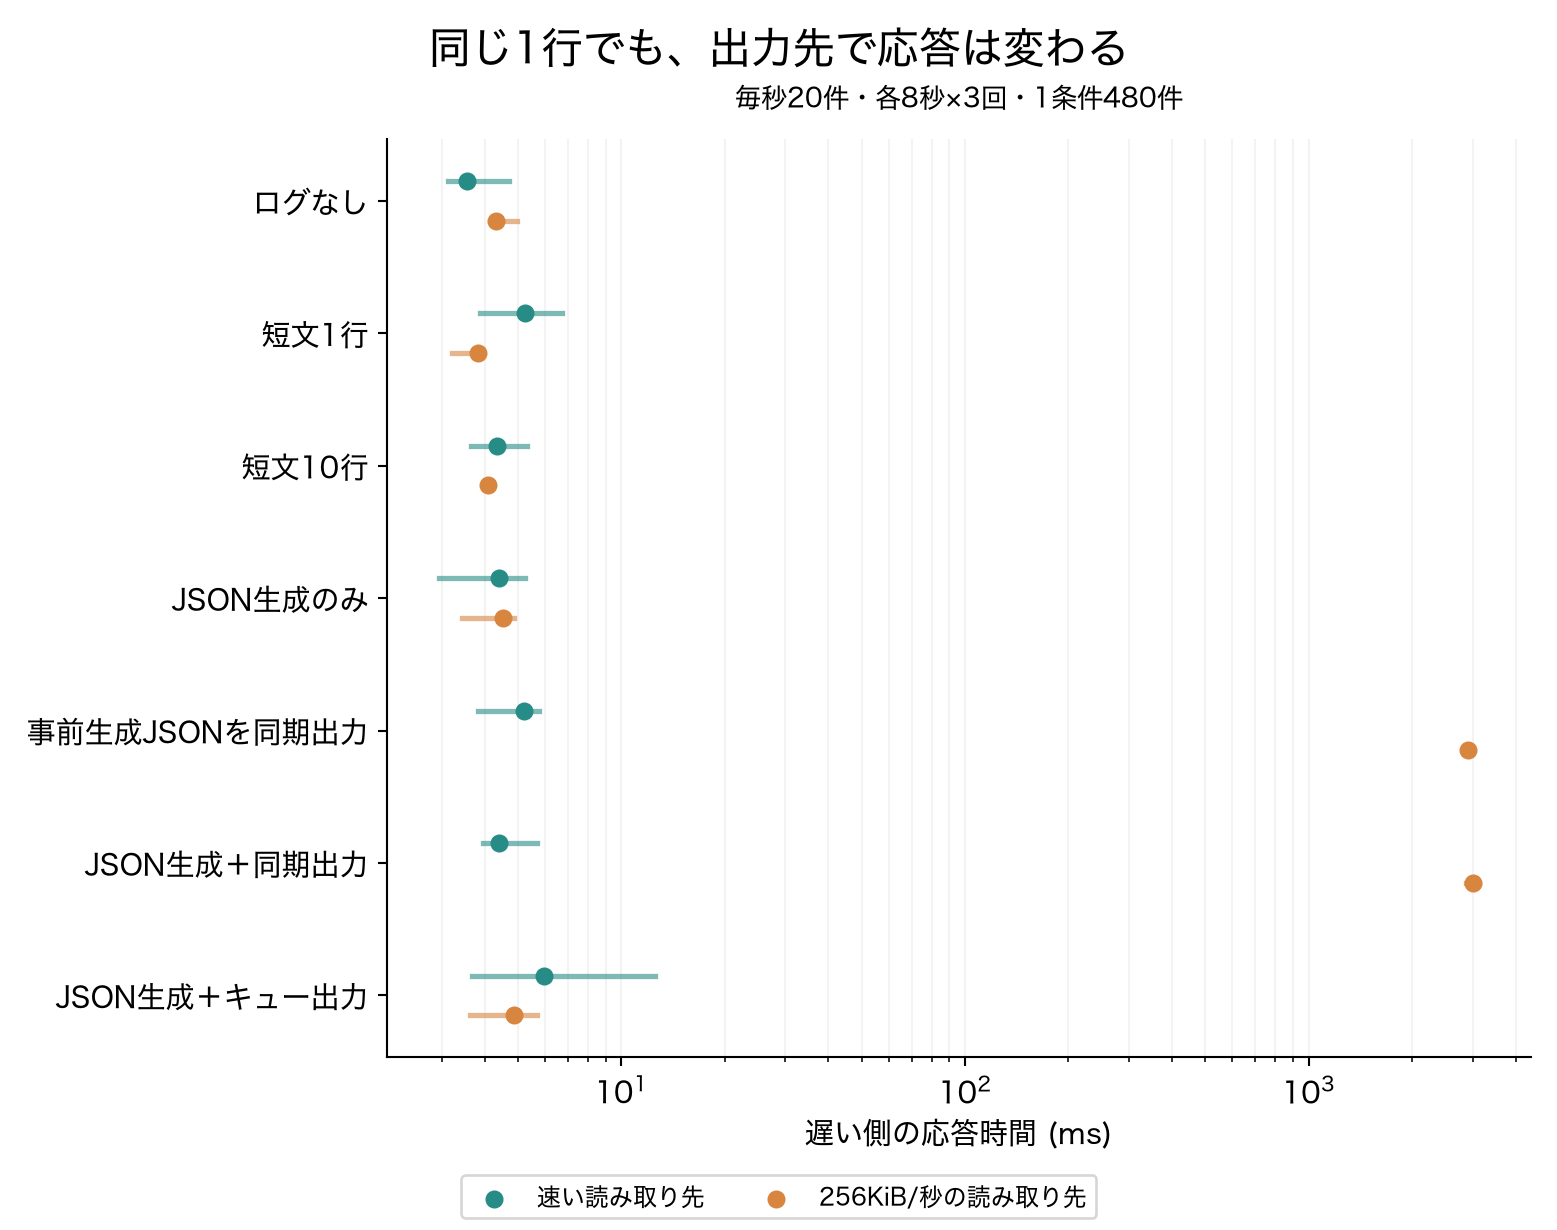
短文1行と10行の順位は、行数の順には並んでいません。速い読取先で測った3回の値は、ログなしが3.12〜4.69ms、短文1行が3.87〜6.70ms、短文10行が3.66〜5.31msで重なっています。この短時間の測定から「短文1行の追加で必ず何ms遅くなる」とは言えません。
違いがはっきり出たのは、大きなJSONを遅い読み取り先へ同期出力する条件でした。毎回JSONを生成する条件で、3回の測定から得た値は2.87〜3.13秒。事前に文字列を作っておいても2.87〜2.96秒でした。生成を省いた対照でも同じ秒単位の待ちが残っています。
JSONを作る時間より、書き込みで待つ時間が長かった
API内でも、JSON生成とlogger呼び出しの区間を分けて測りました。遅い読み取り先での1リクエスト当たりの平均は次のとおりです。
| 条件 | JSON生成相当の区間 | logger呼び出し側の区間 |
|---|---|---|
| JSON生成のみ | 97µs | 出力なし |
| 事前生成JSONを同期出力 | 毎回の生成なし | 55,319µs |
| JSON生成+同期出力 | 105µs | 55,255µs |
| JSON生成+キュー出力 | 103µs | 122µs |
この区間には、計測用の時刻取得、出力量の計数や文字列の符号化なども含みます。ロガー単体の純粋な性能値ではありません。また、API内の平均値と、クライアントが観測する遅い側の応答時間は別の指標です。1つのリクエストの書き込み待ちがイベントループを止めると、その間に来たリクエストも待ちます。
今回の出力要求は、16KiB × 毎秒20件 = 毎秒320KiB。読み取り上限の毎秒256KiBを超えます。FIFOの容量は64KiBでした。バッファが埋まると同期書き込みが待ち、その待ちが同じイベントループで処理するHTTPにも及ぶ、という仕組みで観測結果を説明できます。
短文10行なら毎秒25KiBです。同じ読み取り上限に十分収まります。「10行だから遅い」よりも、「どれだけのバイト数を、どの速さの相手へ渡すか」が効いた比較でした。
キューは待ちを移す。その後もログは残る
キュー出力では、遅い読み取り先でも480件をまとめた遅い側の応答時間は4.86ms、各回では3.63〜5.67msでした。ところが、APIが最後の応答を返した時点で、すべてのログが読まれていたわけではありません。
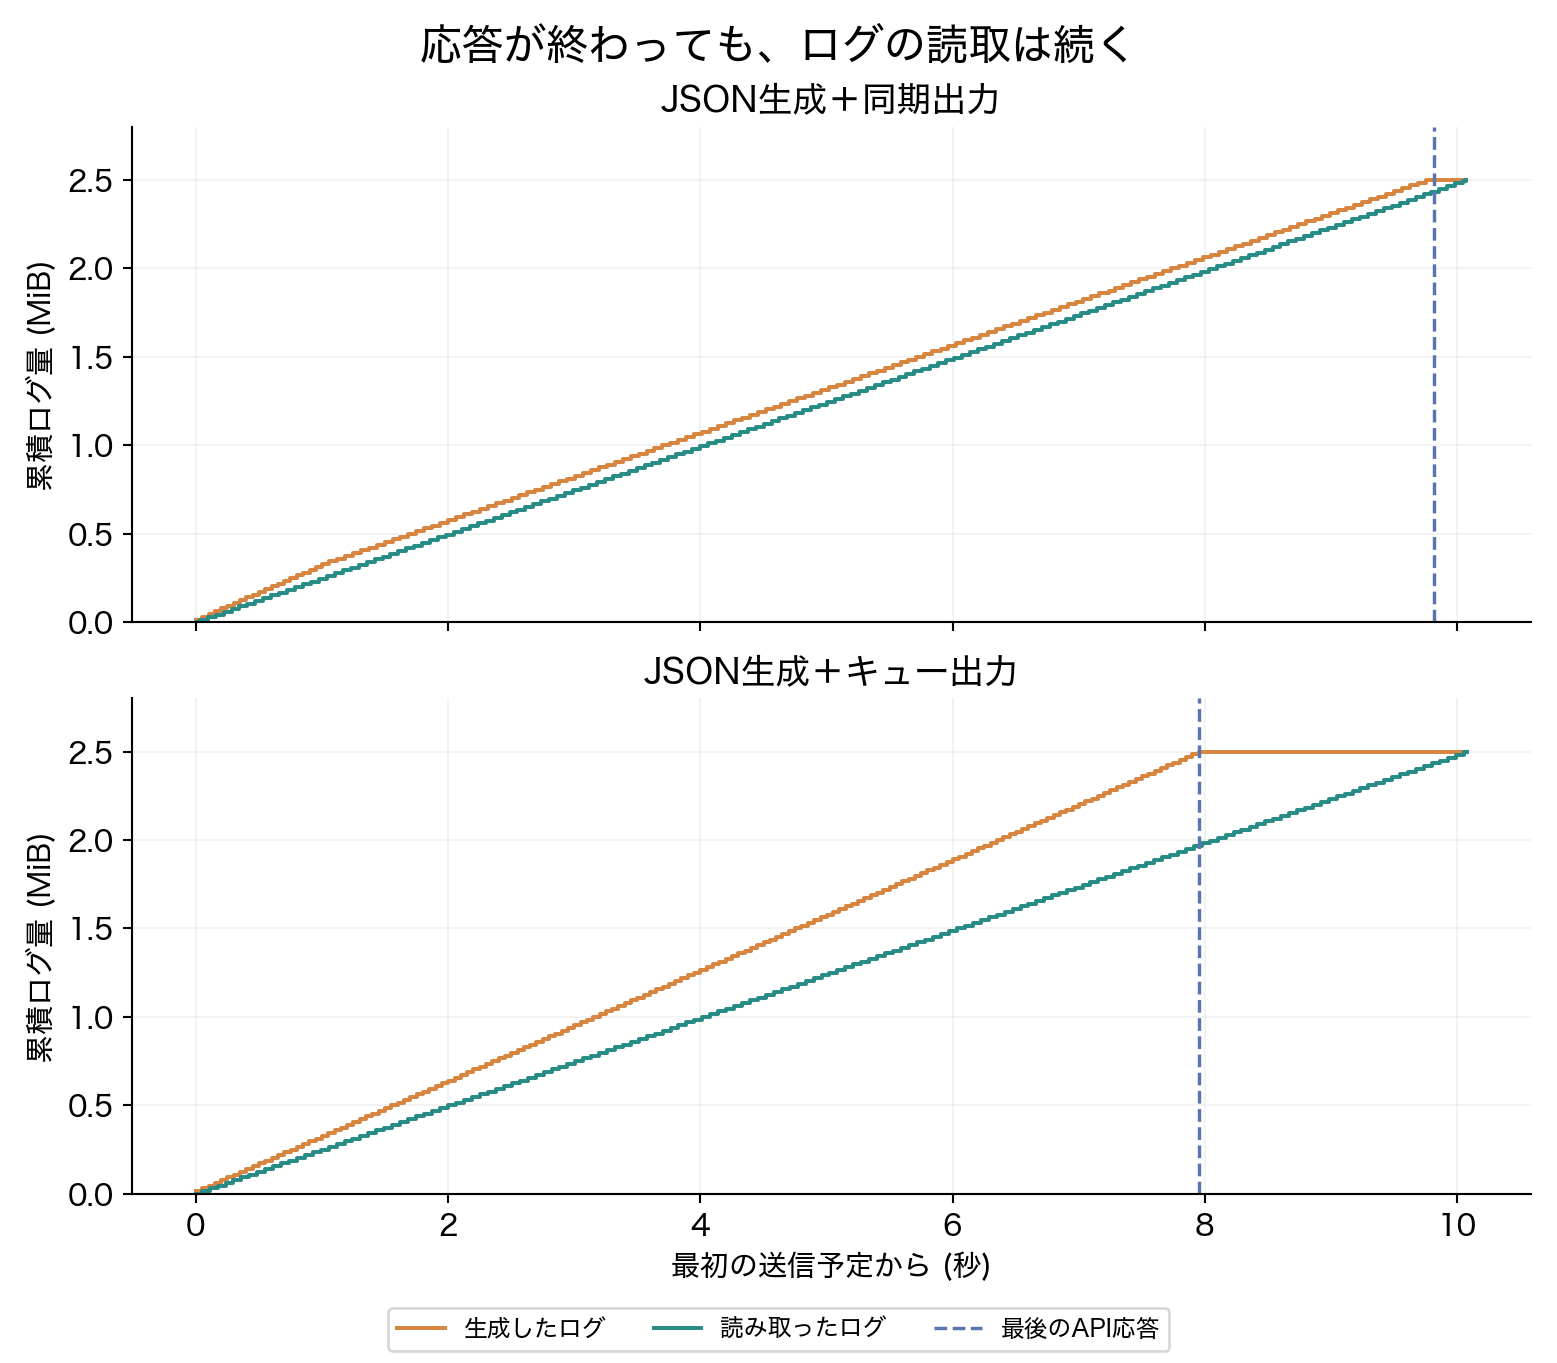
キュー出力では、生成したログ量と読み取ったログ量の差の最大推定値が548KiBになりました。これは直前の読み取りサンプルを使った値なので、実際の同時刻の未読量を上振れしえます。アプリ内・FIFO・キューを合わせた未読分の推定であり、キューそのものの使用量ではありません。
最後のAPI応答から読取完了までは平均2.11秒、3回とも2.10〜2.11秒でした。同期出力では平均0.25秒です。同期方式は応答前に待ち、キュー方式は応答後にも仕事を残しています。
今回のキュー上限は256件です。8秒間の負荷では満杯にならず、ログを落とさずに全量を読み取れました。ただし、入力が読取能力を上回ったまま負荷を続ければ、未処理分は増えます。満杯になるまでの連続負荷や、到達時の応答は今回測っていません。実装上は満杯や出力エラーを実験失敗として扱いました。
CPUが低くても、応答が速いとは限らない
遅い同期出力では、APIの平均CPU使用量は約0.011コアでした。キュー出力は約0.019コア。応答が秒単位で遅くなった同期方式のほうが、平均CPUは低い結果です。
これはログ処理の総仕事量が減った証拠にはなりません。CPUを使わずに書き込みを待つ時間が増え、平均を取る応答観測区間も長くなっています。CPUだけでは、APIがどこで待っているかを判断できません。
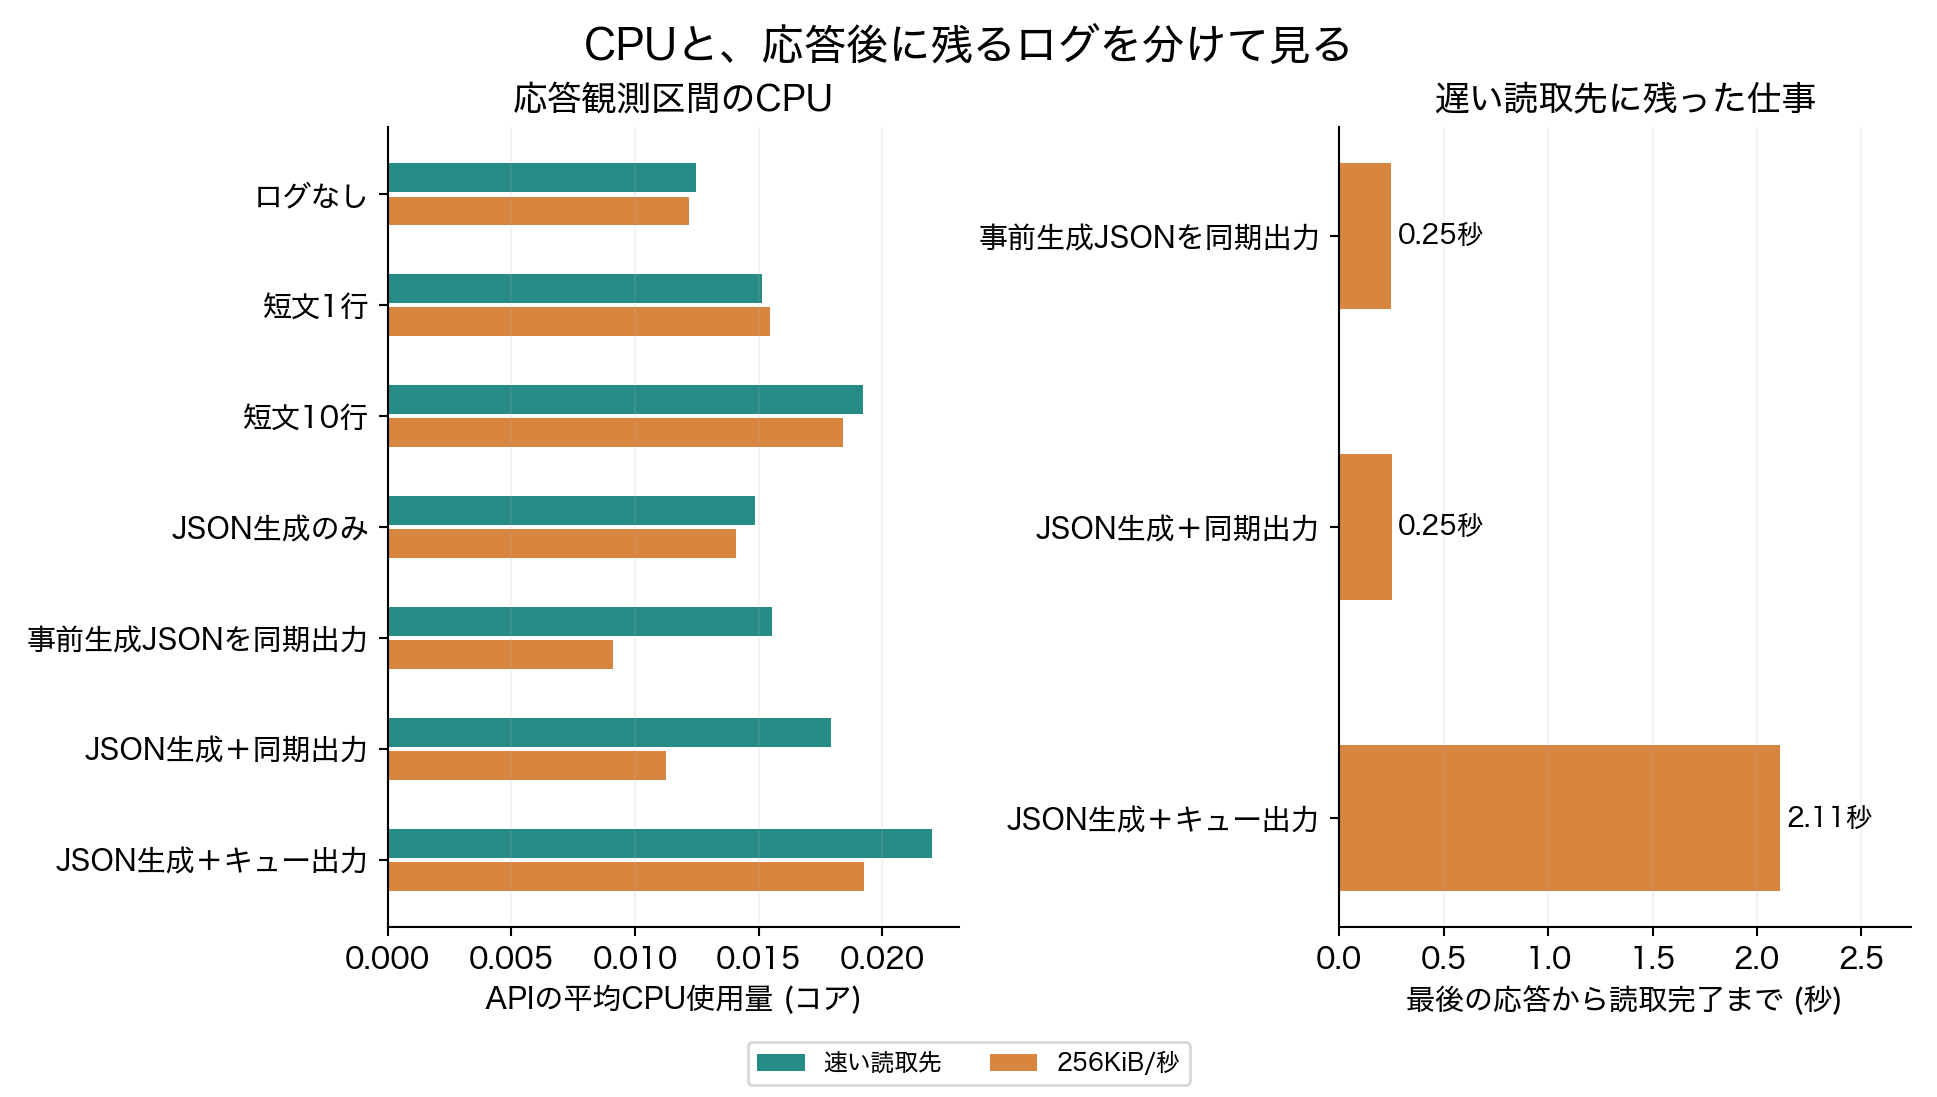
処理件数も、どこまでを完了と呼ぶかで見え方が変わります。毎秒20件の予定送信に対して、遅い読み取り先での結果は次のようになりました。
| 条件 | API応答まで含む完了件数/秒 | 全ログの読取完了まで含む件数/秒 |
|---|---|---|
| JSON生成+同期出力 | 16.29 | 15.88 |
| JSON生成+キュー出力 | 20.00 | 15.90 |
各列の分母は、最初の送信予定から「8秒」と「最後の応答」の遅い方まで、または、さらに全ログの読取完了を含めた時間です。3回の件数と観測時間を合計して計算しています。ログなし・短文1行・短文10行・JSON生成のみは、API応答まで毎秒20件を完了しました。固定した負荷が終わるまでの比較であり、APIの最大処理能力を測った値ではありません。
自分のAPIで確かめるなら
今回、短いログでは、遅い側の応答時間だけを見ても、小さな追加コストを安定して言い切れませんでした。一方、出力先の能力を超える大きなログでは、APIの待ちと応答後の残り仕事がはっきり分かれました。
ログ追加後に遅くなったときは、まず同じAPIで「生成のみ」「既にある文字列の出力」「生成と出力」を比べると、調べる区間を絞れます。次に1リクエストの行数だけでなく、総バイト数と毎秒の出力量を確認する。CPUが低くても、出力先の待ちは候補に残ります。
キューを試す場合は、HTTPの応答時間と一緒に、未処理量、破棄件数、最後まで読み終える時間を測りたいところです。入力が出力先の能力を超えているなら、キューに加え、記録内容・出力量・読み取り側の能力を見直す必要があります。
測定条件・ばらつき・この実験で分からないこと
- 2026年10月29日、Raspberry Pi 5、4論理CPU、16GBメモリ、Linux/aarch64、Python 3.11.2。同一ホストの127.0.0.1、HTTP/1.1、1リクエスト1接続。APIは専用の単一イベントループで、特定のWebフレームワークや本番アプリの計測ではない。
- 各回でAPIを起動し直し、2件をウォームアップ。全ログ読取後に計数をリセットし、毎秒20件・8秒の本計測を開始。14組を3周し、周ごとに開始位置をずらした。予備測定は本集計に含めていない。
- 遅い側の応答時間は昇順の
ceil(件数 × 0.99)番目。本文の点は480件の集計、図の線は160件ずつの3回の範囲。短時間・少数回のため、小さな差やまれな遅延には追加検証が必要。信頼区間や統計的有意差は求めていない。 - CPUはウォームアップ後から応答観測区間の終了までをcgroupで取得し、後続の統計取得処理を除いた。キューではその間に進む別スレッドの出力も含む。API全体の平均であり、方式間で同じ総仕事量を計り終えた区間とは限らない。
- APIと送信・読取側をそれぞれ0.25コアに制限。メモリ上限は128MiB/256MiB、実行時間・出力量にも上限を設定。ホスト全体のCPUは約1秒ごとの観測で中央値7.3%、最大53.9%、load1は最大0.79。共有ホストの他の処理も含む。停止基準には達せず、終了後は専用プロセス・FIFO・一時ファイルを片付けた。
- 遅い読み取り先は4096バイトの読取りごとに待つ方式で、256KiB/秒は上限。読取完了はディスクへの永続化や外部サービスの受領完了を意味しない。
- 出力全量をバイト数・改行数・SHA-256で照合。ログ本文は保存せず破棄。スレッド数の異なるWebサーバー、別言語のロガー、ファイル・ネットワーク出力、無期限の負荷では結果が変わりうる。
集計値は条件別CSV、ばらつきは42回の結果、再集計には6,720件の応答データと時系列データを参照できます。列と集計方法も添えました。
KamuiDashについて
KamuiDashは、GitHubからWebアプリをデプロイできる、日本リージョン対応のPaaSです。