
新增日誌後API變慢時,應該修改哪裡,取決於是建立日誌內容太耗時,還是寫出日誌時必須等待。
因此,我們在同一個API改變日誌量、寫出方式與輸出端的速度,比較建立內容的時間與等待寫入的時間,如何影響回應。
讀完後,你會知道如何在自己的API比較「只建立日誌」與「實際寫出日誌」,縮小延遲發生的位置。我們也會說明,把寫入交給其他處理時,為什麼除了回應時間,還需要確認是否留下未完成的日誌工作。
實驗中觀察到的日誌寫入等待
我們建立一個小型API,每收到一個請求,就寫出一行記錄程式動作的「日誌」。
輸出端使用實驗用程式,每接收一小段日誌就加入等待時間,讓輸出端的處理跟不上API寫出的速度。結果,日誌寫入必須等待,有些API回應花了約3秒。
這個條件下的一行日誌,是以JSON格式建立、約16KB(16KiB)的長字串。它不是簡短訊息,而是在一行裡放入大量資料。即使只有一行,寫出量與接收端的速度,也可能讓API等待。
我們也嘗試把日誌寫入與API回應處理分開。回應變快了,但最後一個API回應送出後,日誌讀取仍持續約2秒。回應變快,與日誌處理完成,是不同的結果。
另一方面,128位元組的短日誌從1行增加到10行,在這次條件下,回應並沒有隨行數等比例變慢。以下分開比較建立日誌內容的時間、等待寫入的時間,以及讀完日誌的時間。
在同一個API比較7種日誌處理
實驗使用Python 3.11.2標準函式庫。HTTP API在單一asyncio事件迴圈中執行相同的小型雜湊計算,並回傳相同的JSON回應。改變的只有以下日誌處理。
| 條件 | 每個請求的處理 | 輸出位元組數 |
|---|---|---|
| 不記錄日誌 | 不建立也不輸出日誌 | 0 |
| 短文1行 | 同步輸出固定短文 | 128 |
| 短文10行 | 同一段短文同步輸出10次 | 1,280 |
| 僅產生JSON | 建立JSON字串但不輸出 | 0 |
| 預先產生JSON,再同步輸出 | 輸出啟動時建立的JSON字串 | 16,384 |
| 產生JSON+同步輸出 | 每次建立JSON字串並輸出 | 16,384 |
| 產生JSON+佇列輸出 | 每次建立JSON字串,將輸出交給另一個執行緒 | 16,384 |
位元組數包含換行。大型JSON是固定的合成資料,主要內容是一段很長的ASCII字串。它不是實際請求的完整紀錄,也沒有測量複雜物件的走訪或敏感欄位遮罩成本。
同步輸出使用logging.StreamHandler,佇列輸出使用QueueHandler與QueueListener。輸出目標是專用FIFO,也就是在行程之間傳遞位元組的管道。依照StreamHandler的行為進行寫入與flush,再由另一個行程讀取。
讀取端分成「不刻意限制速度」與「上限256KiB/秒」兩種。這不是實際磁碟持久化或外部日誌服務傳輸效能的測試。
- 應用程式處理
- 產生JSON
- StreamHandler
寫入與flush - API回應
FIFO沒有空間時,寫入會等待。flush返回,也不代表讀取端已讀完全部內容。
- 應用程式處理
- 產生JSON
- QueueHandler
加入佇列 - API回應
另一個執行緒繼續處理QueueListener → StreamHandler → FIFO → 讀取端。JSON產生與入列仍留在API路徑。
QueueHandler的官方說明也提到,可以把處理常式移到另一個執行緒。這次實驗仍將JSON產生、呼叫端的日誌格式化與入列保留在API路徑,只把輸出處理常式移到後段。
短日誌的差異小,大型JSON則受輸出端影響
每秒20個請求,以50ms間隔持續發送8秒;每次160個請求都觀察到完成。7種條件×2種讀取端,各重複3次,共42次量測、6,720個請求。HTTP錯誤、日誌遺失、佇列丟棄皆為零。
為了觀察回應延遲,我們除了平均值,也比較較慢一側的回應時間。例如將100個回應由快到慢排列,取第99個回應的時間。這裡將各條件3次、共480個請求合併計算。起點是預定發送時刻,終點是接收完回應本文。建立連線及API堵塞造成的等待也包括在內。
| 條件 | 快速讀取端 | 慢速讀取端 |
|---|---|---|
| 不記錄日誌 | 3.54ms | 4.32ms |
| 短文1行 | 5.24ms | 3.83ms |
| 短文10行 | 4.35ms | 4.10ms |
| 僅產生JSON | 4.40ms | 4.51ms |
| 預先產生JSON,再同步輸出 | 5.22ms | 2,912ms |
| 產生JSON+同步輸出 | 4.42ms | 3,005ms |
| 產生JSON+佇列輸出 | 5.97ms | 4.86ms |
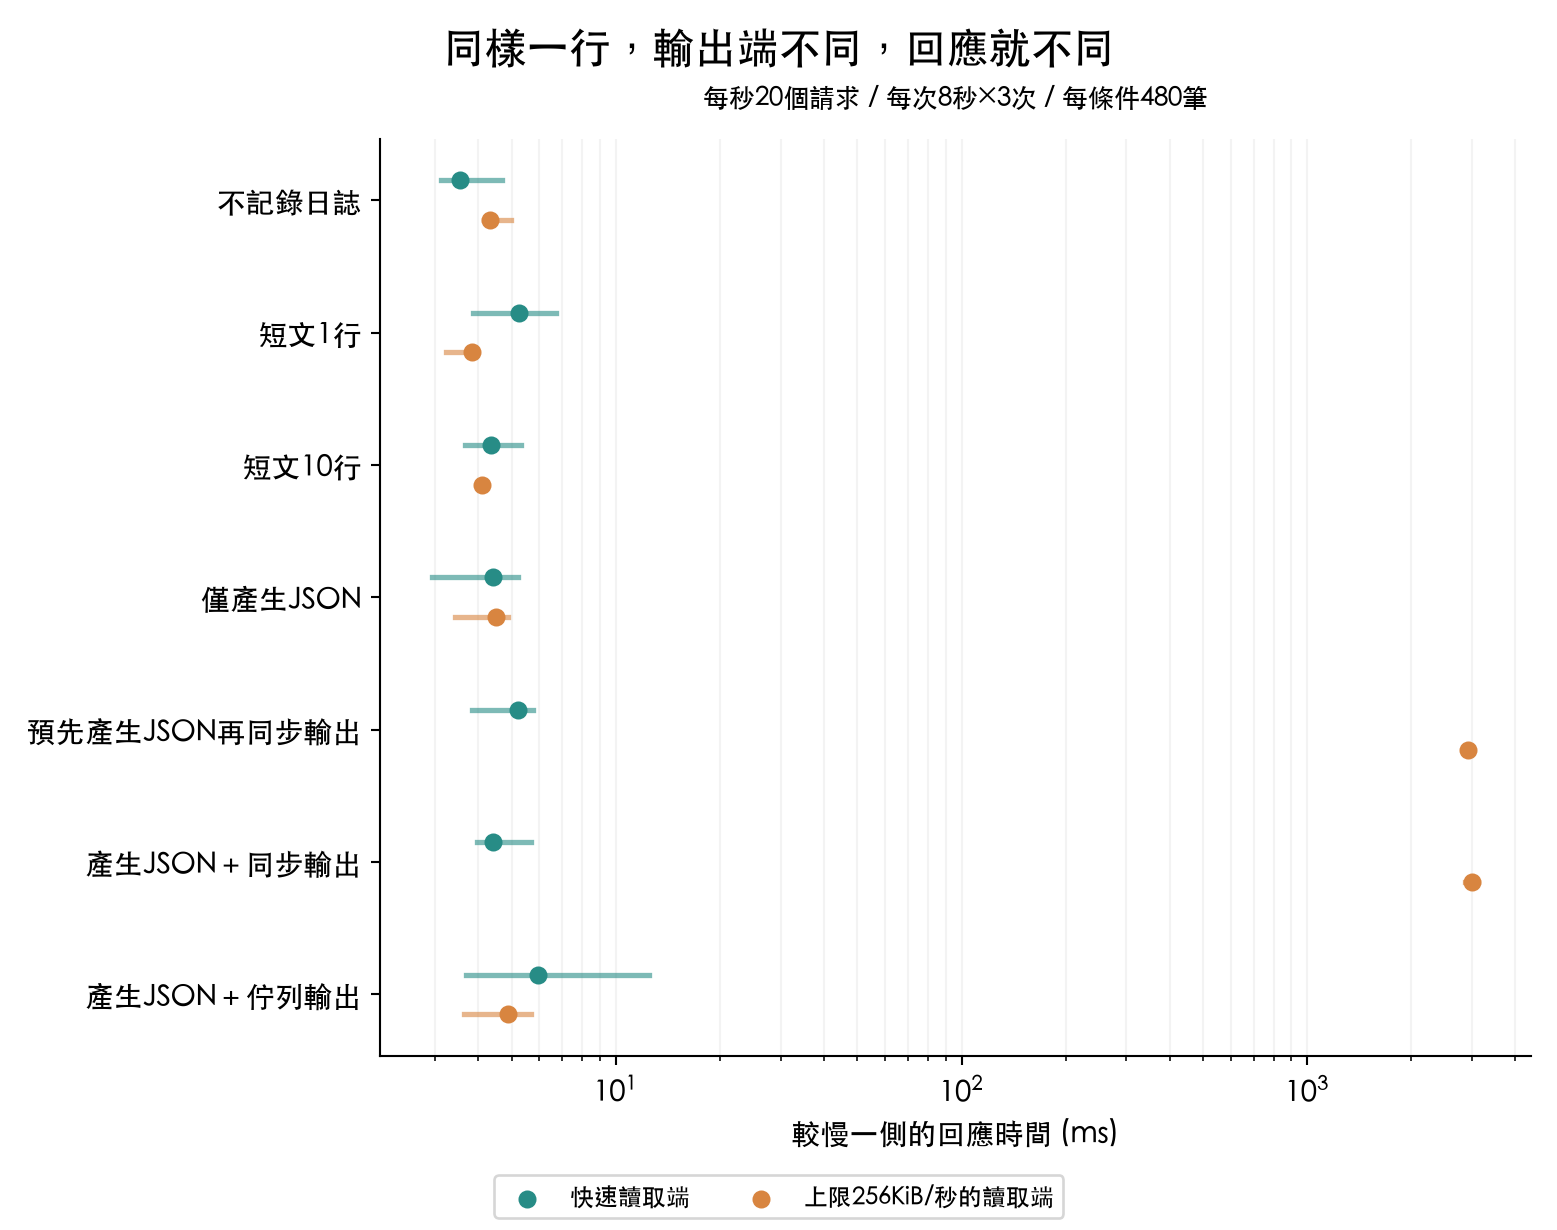
1行與10行的排名並未依照行數排列。在快速讀取端,各次量測值的範圍分別是:不記錄日誌3.12~4.69ms、短文1行3.87~6.70ms、短文10行3.66~5.31ms,範圍彼此重疊。這次短時間量測無法斷言「多一行短日誌一定會增加幾ms」。
差異明顯的是,將大型JSON同步輸出到慢速讀取端的條件。每次產生JSON時,各次量測值為2.87~3.13秒;即使事先建立字串,仍為2.87~2.96秒。省略產生步驟的對照組,依然留下秒級等待。
比起產生JSON,等待寫入花了更多時間
我們也在API內分別測量JSON產生與logger呼叫的區間。慢速讀取端下,每個請求的平均值如下。
| 條件 | JSON產生相當區間 | 呼叫端的日誌處理區間 |
|---|---|---|
| 僅產生JSON | 97µs | 不輸出 |
| 預先產生JSON,再同步輸出 | 不在每個請求產生 | 55,319µs |
| 產生JSON+同步輸出 | 105µs | 55,255µs |
| 產生JSON+佇列輸出 | 103µs | 122µs |
這些區間也包含取得時間戳、計算輸出量、字串編碼等量測開銷,不是logger單獨的純效能值。此外,API內的平均值與客戶端觀測的較慢一側的回應時間是不同指標。一個請求等待寫入而停住事件迴圈時,這段期間到達的其他請求也會等待。
這次要求的輸出量為16KiB × 每秒20個請求 = 每秒320KiB,超過讀取端每秒256KiB的上限。FIFO容量是64KiB。緩衝區填滿後,同步寫入必須等待,進而影響同一事件迴圈處理的HTTP;這個機制可以解釋觀測到的結果。
短文10行則只需每秒25KiB,遠低於相同的讀取上限。這次比較中,比起行數本身,傳遞多少位元組、接收端能讀多快,更能說明差異。
佇列把等待移走,回應後仍留下日誌
使用佇列輸出時,即使讀取端較慢,合併480個請求後,較慢一側的回應時間仍為4.86ms,各次為3.63~5.67ms。不過,最後一個API回應送出,不代表所有日誌都已讀完。
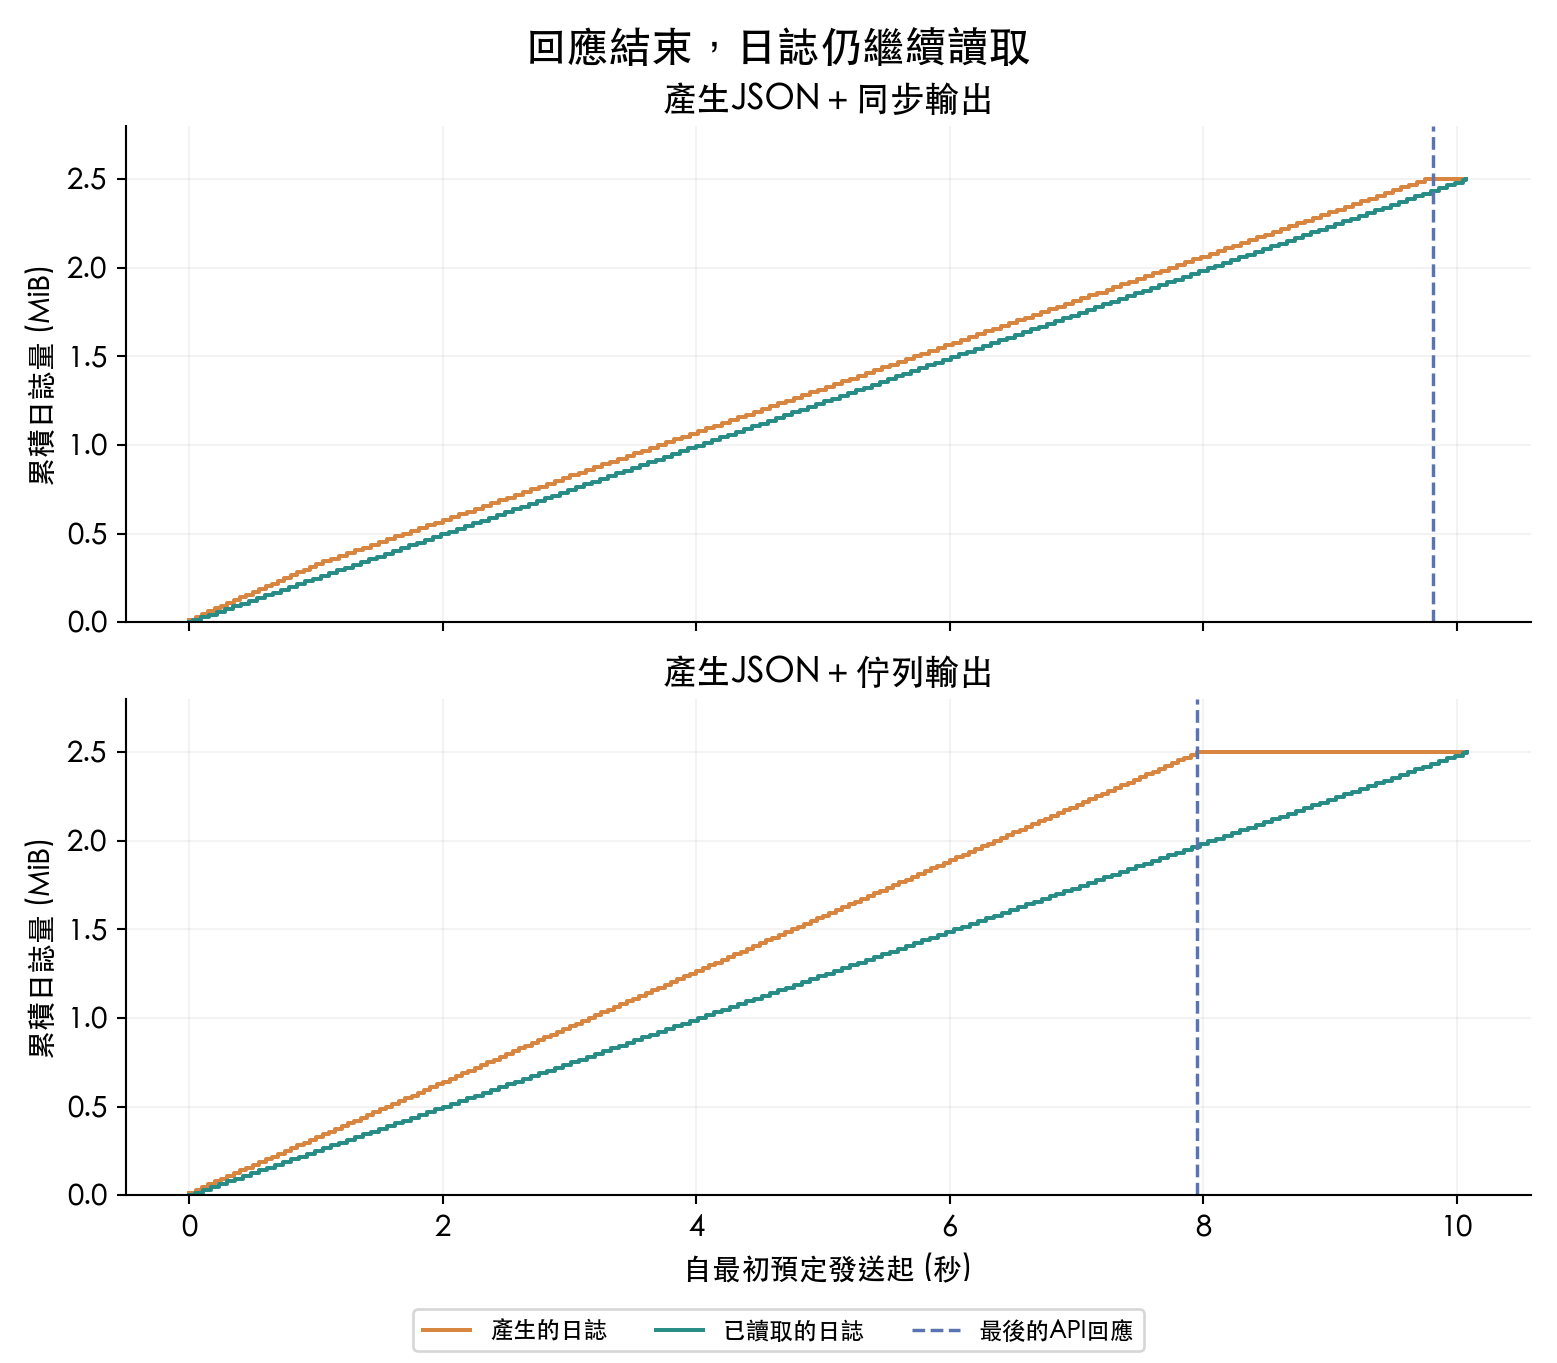
佇列輸出條件下,產生日誌量與已讀取量之差的最大估計值為548KiB。這個估計使用前一個讀取取樣點,因此可能高估同時刻的未讀量。它包含應用程式、FIFO與佇列中的未讀部分,不是佇列本身的占用量。
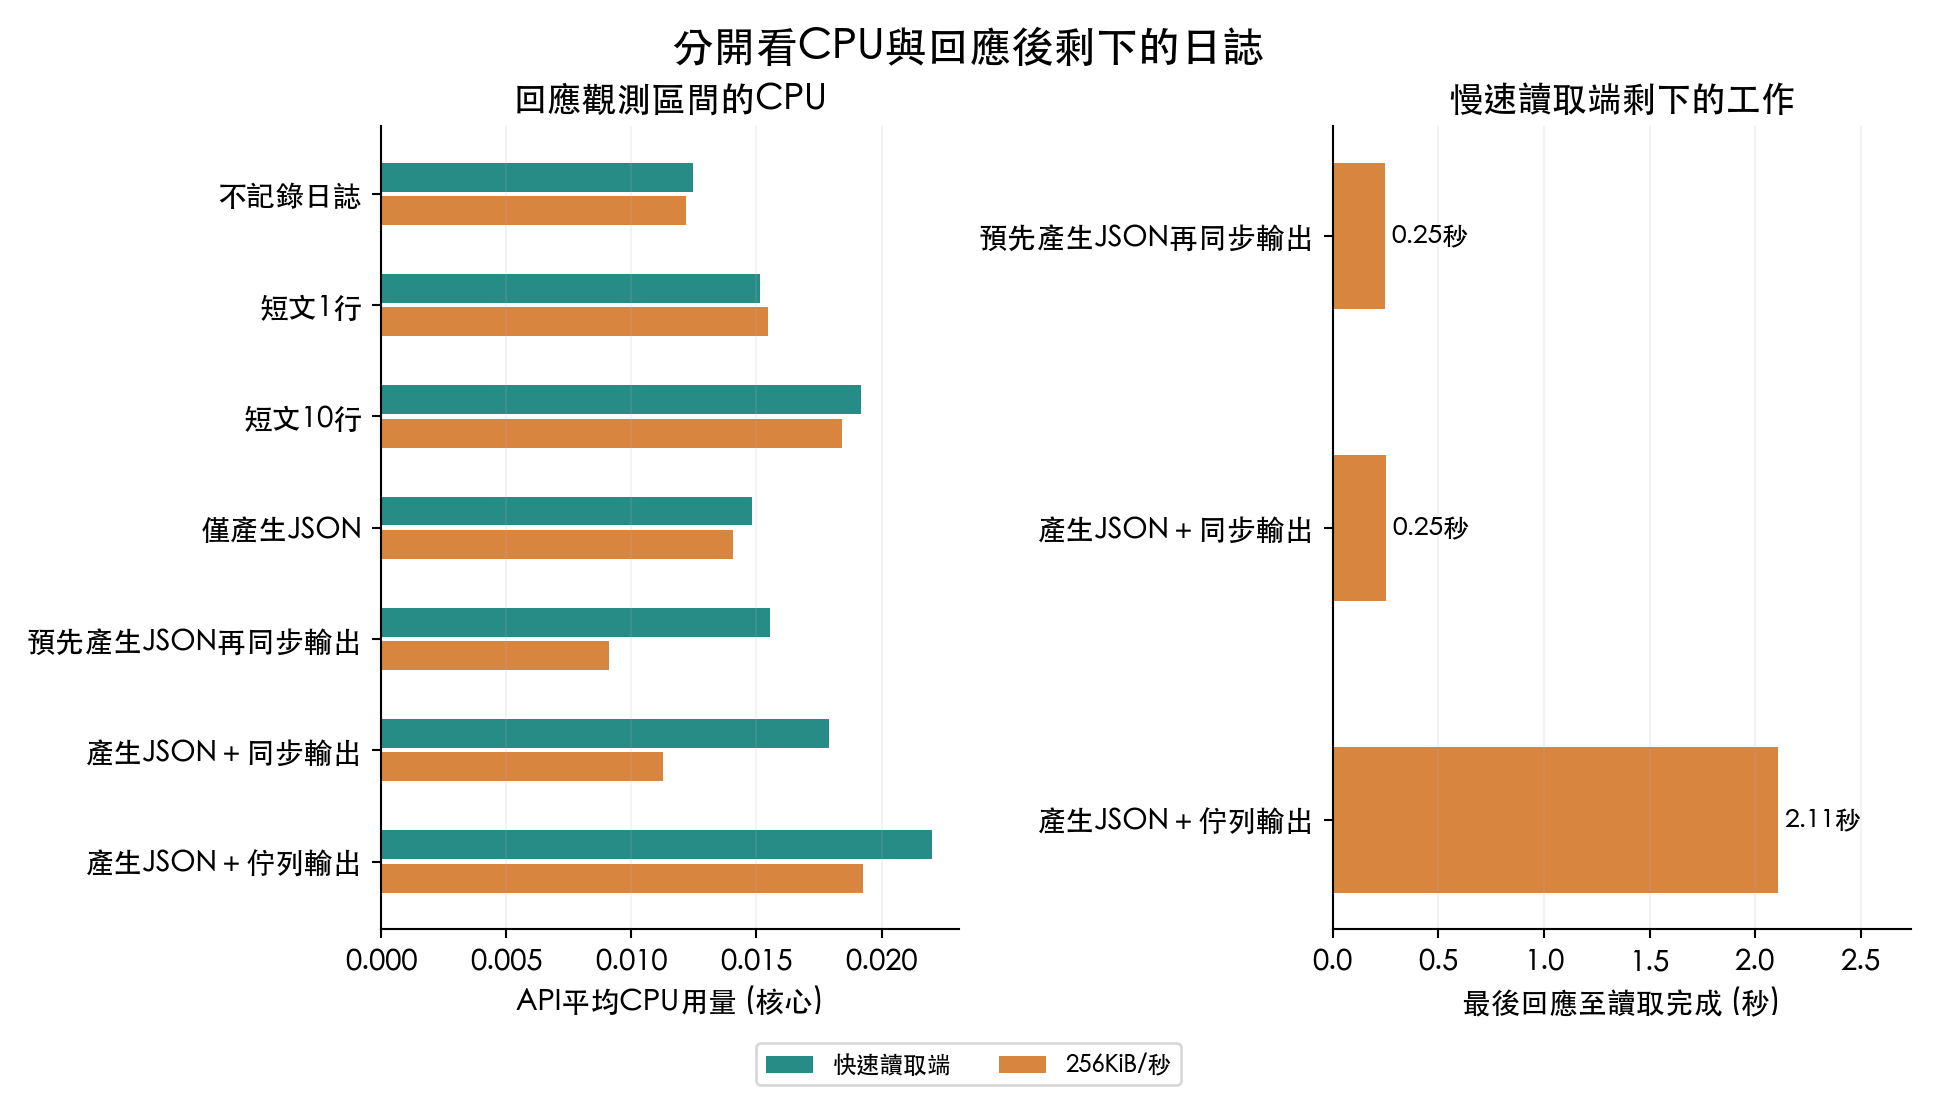
最後一個API回應到全部日誌讀完,平均是2.11秒,3次都在2.10~2.11秒之間。同步輸出則平均為0.25秒。同步方式在回應前等待,佇列方式則在回應後也留下工作。
這次佇列上限是256筆。在8秒的負載下,佇列沒有滿,也沒有丟失日誌,全部內容都已讀完。不過,如果輸入持續超過讀取能力,未處理工作就會增加。這次沒有持續施加負載直到佇列滿,也沒有測量滿載時的回應。實作上,佇列滿或輸出錯誤會視為實驗失敗。
CPU用量低,不代表回應快
對慢速讀取端同步輸出JSON時,API平均CPU用量約0.011核心;佇列輸出約0.019核心。回應慢到秒級的同步方式,平均CPU反而較低。
這不代表日誌處理的總工作量減少了。等待寫入時不使用CPU的時間增加,計算平均值的回應觀測區間也變長。只看CPU用量,無法判斷API在哪裡等待。
每秒完成的請求數,也會隨「完成」的定義而改變。對每秒20個預定請求,在慢速讀取端的結果如下。
| 條件 | 計至API回應完成的請求數/秒 | 計至全部日誌讀完的請求數/秒 |
|---|---|---|
| 產生JSON+同步輸出 | 16.29 | 15.88 |
| 產生JSON+佇列輸出 | 20.00 | 15.90 |
第一欄的分母是從最初預定發送起,到「8秒」與「最後回應」之中較晚的時刻;第二欄還包括全部日誌的讀取完成。先合計3次的請求數與觀測時間,再相除。不記錄日誌、短文1行、短文10行、僅產生JSON這4種條件,計至API回應完成時都是每秒20個請求。這是固定輸入負載結束前的比較,不是API最大處理能力的測量。
在自己的API上,可以怎麼查
這次只看短日誌中較慢一側的回應時間,還無法穩定量化小幅的額外成本。但當大型日誌超過輸出端能力時,API路徑的等待與回應後剩下的工作,就能清楚分開。
新增日誌後若API變慢,可以在同一API比較「僅產生」「輸出既有字串」「產生並輸出」,縮小需要調查的區間。接著除了每個請求的行數,也要看總位元組數與每秒輸出量。即使CPU用量低,輸出端等待仍是可能原因。
嘗試佇列時,應把未處理量、丟棄筆數、全部讀完所需時間,與HTTP回應時間一起測量。如果輸入超過輸出端能力,除了使用佇列,也需要重新檢視記錄內容、輸出量或讀取端能力。
量測條件、變動範圍,以及這次實驗無法回答的事
- 2026年10月29日量測:Raspberry Pi 5、4個邏輯CPU、16GB記憶體、Linux/aarch64、Python 3.11.2。同一主機的127.0.0.1、HTTP/1.1、每個請求建立一條連線。專用API使用單一事件迴圈,並非特定Web框架或正式應用程式的效能測試。
- 每次重新啟動API行程,先執行2個暖身請求。讀完所有暖身日誌後重設計數,再開始每秒20個請求、持續8秒的正式量測。14種組合跑3輪,每輪輪換起始位置。預備量測未納入正式集計。
- 較慢一側的回應時間取排序後第
ceil(筆數 × 0.99)筆。本文的點是合併480筆後的值;圖上的範圍來自每次160筆、共3次量測。時間短、重複次數少,小差異或罕見延遲仍需額外驗證。未計算信賴區間或統計顯著性。 - CPU以cgroup計數器量測,區間從暖身後至回應觀測區間結束,排除後續取得統計資料的處理。佇列條件也包含這段時間內另一個執行緒進行的輸出。這是API整體的平均值,不保證各方式的區間都涵蓋相同的已完成日誌工作量。
- API與負載產生/讀取端各限制為0.25核心,記憶體上限分別128MiB/256MiB,另設執行時間與輸出量上限。主機整體CPU約每秒取樣,中位數7.3%、最大53.9%,load1最大0.79;其中也包含共用主機上的其他工作。未達停止條件。結束後已移除專用行程、FIFO與暫存檔。
- 慢速讀取端每讀取4,096位元組便等待,因此256KiB/秒是上限。讀完不代表已持久化至磁碟,也不代表外部服務已確認接收。
- 所有輸出皆以位元組數、換行數與SHA-256核對。日誌內容直接丟棄、不儲存。不同執行緒模型的Web伺服器、其他語言的logger、檔案或網路輸出、無限期負載,都可能得到不同結果。
集計值可參考各條件CSV、42次量測結果;重新計算可使用6,720個請求的回應資料與時間序列資料。另附欄位與集計方法。
關於KamuiDash
KamuiDash是支援日本區域的PaaS,可直接從GitHub部署Web應用程式。