
Pythonで小さなデータを80,000個作り、そのうち98%以上の参照を捨てたところ、メモリ使用量がほとんど下がらないケースがありました。
「参照を捨てる」は、変数やリストからデータへのつながりを切る操作です。一方、ガベージコレクション(GC)は、プログラムから使えなくなったデータを回収する仕組みです。ほかの変数やリストからまだ使えるデータは、GCを動かしても回収されません。
残していた参照は、64個に1個だけです。GCを手動で動かしても、使用量はほとんど変わりませんでした。ところが、最後に残した参照も捨てると、使用量は大きく減りました。
大部分のデータを捨てても、GCを呼んでも減らなかったのに、最後の少量を手放すと減る。この結果は、「データを使い終えたこと」と「OSから見えるメモリ使用量が減ること」を分けて考える手がかりになります。
この記事では、このとき何が残っていたのかを4条件の比較から読み解き、処理後にメモリが下がらないとき、何を調べればよいのかにつなげます。
測った指標はRSS(Resident Set Size)です。RSSは、実行中のプログラム(プロセス)に対応するメモリのうち、今、物理メモリ(RAM)に載っている量を表します。Pythonのデータだけでなく、実行コードや共有ライブラリなども含むため、RSSと「まだ生きているPythonのデータ量」は同じものではありません。LinuxのRSSの説明
実験では、参照を捨てるとすぐにRSSも減る場合と、GCで回収するまで残る場合、少量の参照を残したためGCでも減らない場合に分かれました。この違いを、処理後のメモリを調べる順序につなげます。
4条件で、参照を捨てた後のメモリを比べる
使用したのはCPython 3.11.2、Linux 6.12、aarch64、glibc 2.36です。小さな割り当てを管理するPython標準のpymallocを有効にし、次の4条件を比べました。
| 条件 | 作るもの | 「捨てる」の操作 |
|---|---|---|
| 大きなバッファ | 32 MiBのbytearrayを1個 | その参照を捨てる |
| 小さなバッファ | bytearray(256)を80,000個 | リストごと捨てる |
| 少量だけ保持 | 同じ80,000個 | 64個ごとに1個、計1,250個だけ別のリストで保持 |
| 循環参照 | 自分自身への参照とbytearray(256)を持つNodeを80,000個 | 外側のリストを捨てる |
ここでの256は、bytearrayの中身のバイト数です。オブジェクトの管理領域やリストの分は別に必要なので、80,000×256バイトがRSSの増分になるわけではありません。
各条件を新しいプロセスで3回測り、それぞれの中で2周期繰り返しました。参照を捨てた直後、1秒後、3秒後を記録し、その後にgc.collect()を実行します。少量保持の条件では、最後に残した参照も解放します。
実験で分かったこと:同じ「捨てる」でも戻り方は違う
| 条件 | 生成直後 | 参照を捨てた直後 | 3秒後 | 手動GC後 | 残りの参照も解放後 |
|---|---|---|---|---|---|
| 大きなバッファ | +32.00 | +0.00 | +0.01 | +0.01 | +0.01 |
| 小さなバッファ | +25.87 | +0.86 | +0.86 | +0.84 | +0.84 |
| 少量だけ保持 | +25.90 | +25.61 | +25.61 | +25.61 | +0.45 |
| 循環参照 | +30.32 | +30.02 | +30.02 | +0.90 | +0.90 |
単位はMiB、各周期の生成前からのRSS増分の中央値です。1 MiBは1,048,576バイト。3プロセス×2周期の6観測をまとめていますが、同じプロセス内の2周期を独立した反復とは扱っていません。
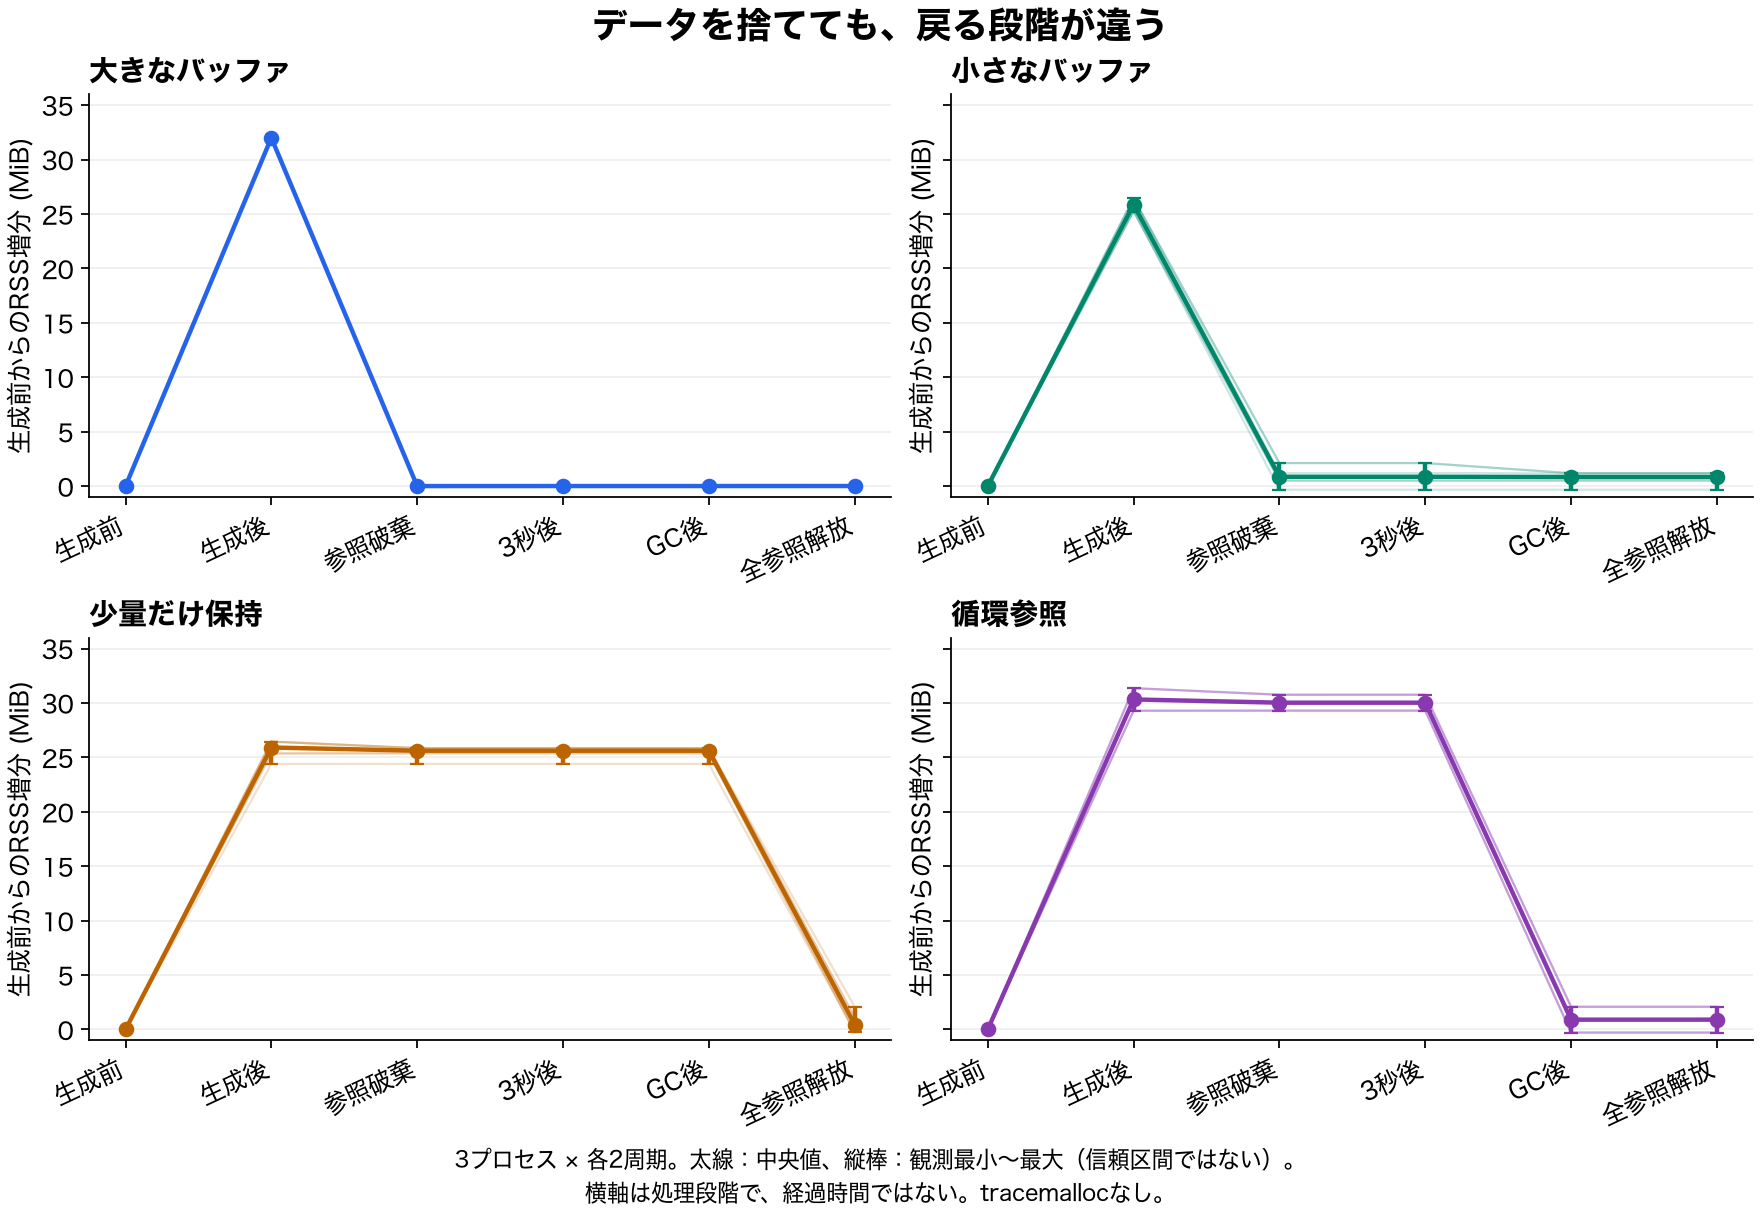
表から分かったのは、データを「捨てた」後に必要な操作が、参照の状態によって違うことです。
- 32 MiBの大きなバッファは、参照を捨てた直後にRSSの増分もほぼ0へ戻りました。小さなバッファも、すべての参照を捨てた条件では大部分が直後に減っています。
- 循環参照では、3秒待っても約30.02 MiBの増分が残り、手動GC後に約0.90 MiBへ減りました。
- 小さなバッファを64個に1個、約1.6%だけ保持すると、GC後も約25.61 MiBの増分が残りました。最後の参照を捨てると約0.45 MiBへ減りました。
「時間がたてば減る」「GCを呼べば減る」と一つの原因で説明することはできませんでした。 とくに、データの98%以上を捨てても、RSSが同じ割合で減るわけではない点が重要です。なぜこうなるのかを、メモリを管理する仕組みから見ていきます。
なぜ違うのか:参照・回収・OSへの返却を分ける
- 1. オブジェクトの寿命
参照カウントや循環GCが、不要になったPythonオブジェクトを回収する。
見るもの:参照・GC回収数・Pythonの追跡対象量 - 2. allocator内部の空き
割り当てを管理する仕組みが、空いた領域を次の生成に再利用できる。
pymallocやglibcなど。サイズ等で経路は異なる。 - 3. OSから見た常駐ページ
プロセスに対応づけられた物理ページが減ると、RSSも下がる。
見るもの:RSS・PSS・Anonymous・Swap
Pythonでオブジェクトが回収されると、そのオブジェクトのために使っていた領域を再利用できるようになります。しかし、割り当てを管理する仕組み(allocator)がその領域を手元に持っていれば、OSから見た常駐メモリはすぐには減りません。Pythonのメモリ管理では、Python内部に複数の割り当て・キャッシュの仕組みがあることが説明されています。
循環参照は、3秒待つだけでは回収されなかった
CPythonには参照カウントによる回収があり、循環参照を見つけるGCがそれを補います。たとえば次のNodeは、自分自身への参照を持っています。
class Node:
    def __init__(self):
        self.link = self
        self.payload = bytearray(256)

nodes = [Node() for _ in range(80_000)]
del nodes  # 外側のリストを消しても、Nodeの自己参照は残る
これは関係を示す簡略例です。測定コードでは、属性用の追加dictを作らない__slots__なども固定しています。
循環参照の条件では、全Nodeを外側のリストで保持したまま一度フルGCを実行し、回収数が0であることを確認しました。この事前GCはオブジェクトの世代も変えます。 その後に外側の参照を捨てると、3秒後もRSSはほぼ変わらず、標本として追った32個も全て生存していました。
手動GCでは毎回80,000個のNodeが回収され、標本は全て消滅しました。RSS増分の中央値も約30.02 MiBから約0.90 MiBへ下がりました。回収数はNodeの個数であり、付随するbytearrayの個数を表しているわけではありません。
自動GCは有効でしたが、参照を捨ててから3秒後までGCイベントは増えませんでした。CPython 3.11の自動GCは割り当てと解放のカウンターを使うので、何秒待ったかだけで回収時刻が決まるわけではありません。この実験も、事前GC後に新しい処理をほぼ行わず待つ条件です。GCの仕様
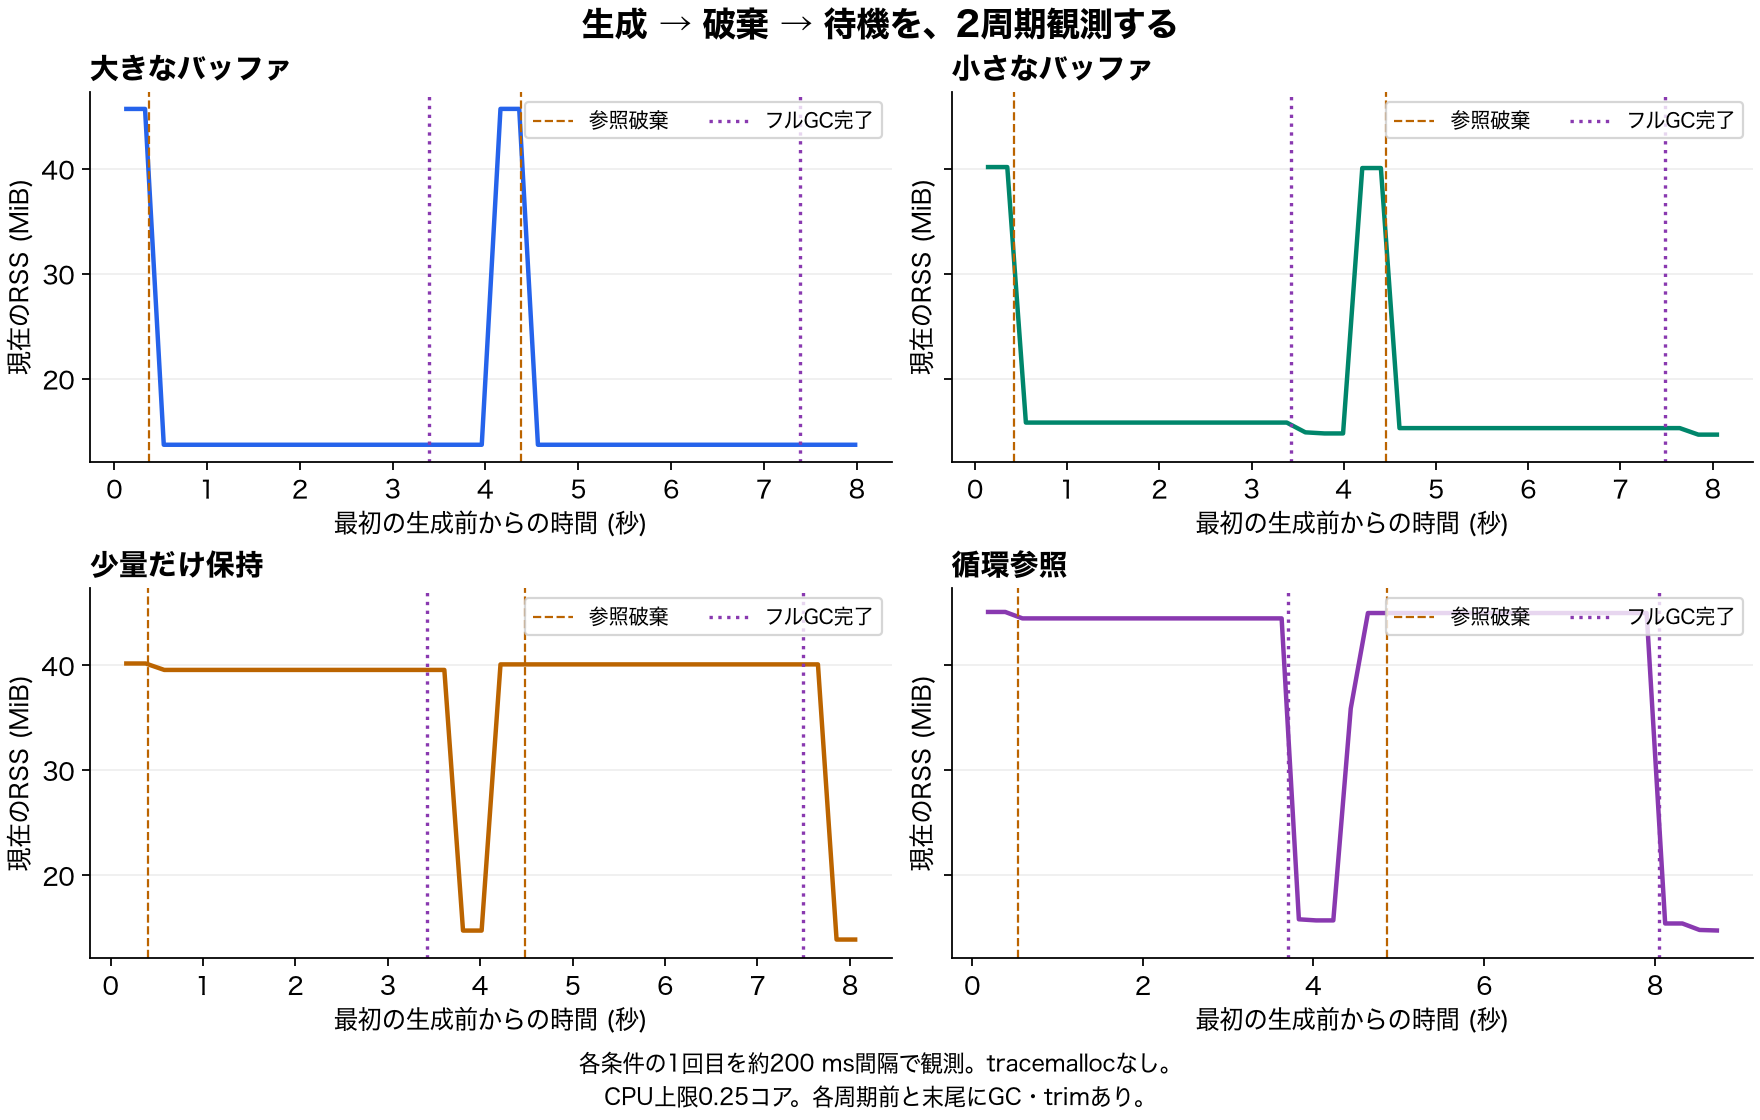
手動GCにかかった実時間の中央値は146.9 ms、プロセスCPU時間は38.8 msでした。CPUを0.25コアに制限しており、実時間にはCPUを使えず待つ時間も含まれます。この実時間を、本番アプリのGC停止時間として使うことはできません。
約1.6%を残しただけで、なぜ大きな領域が残るのか
少量保持では、80,000個中1,250個をリストに残しました。手動GCは、生きている参照があるオブジェクトを勝手に捨てることはできません。ただし、残したデータ量は全体の約1.6%です。RSSもその程度まで減るように思えますが、今回の観測はそうなりませんでした。
pymallocは512バイト以下の小さな割り当て向けの仕組みで、64ビット環境では1 MiBのアリーナという領域を使います。アリーナの中に、さらに小さな割り当てが入ります。空いたブロックを再利用できることと、アリーナを丸ごと返せることは別です。pymallocの仕様
空きブロックを含む領域全体が空けば、返却候補になる。
生存データの場所を保ったまま、同じ領域全体は手放せない。
空きブロック 生存オブジェクト
今回、残りの参照を解放するとRSSも大きく減ったことは、このような領域の残り方と整合します。ただし、全アリーナの配置や別allocatorとの比較は測っていないので、残存RSSの全量を特定の内部構造だけで説明できたわけではありません。
次にメモリが下がらなかったら、この順で確認する
まずは、普段使っているメモリの監視画面と、Pythonのprint()で調べられるところから始めます。開発環境で、処理後のメモリ使用量と、コードが残しているデータの件数を一緒に見ます。
1. 同じ処理を繰り返して、メモリの数字をメモする
OSのプロセス一覧や、普段使うアプリの監視画面で、調べたいPythonのメモリ使用量を開きます。どのプロセスか分からなければ、調べたいPythonコードで次を実行すると、そのプロセスの番号(PID)が分かります。os.getpidの説明
import os
print("このPythonのPID:", os.getpid())
そのPythonを起動したまま、同じ入力・同じ処理量で数回実行し、毎回、処理が終わった直後のメモリ使用量をメモします。「最初に増えた後はほぼ同じ値なのか」「処理のたびに増えるのか」を見ます。毎回Pythonを終了して起動し直すと、それまでにたまったものも消えるため、この比較には混ぜません。数回横ばいだったことだけで、メモリリークがないと確定するわけではありません。
比較には、同じ画面の同じ項目を使います。監視画面の「メモリ」が必ずRSSを意味するとは限らないため、この記事のRSSと絶対値を比べる必要はありません。また、「最大使用量」は過去の最大値なので、処理後に下がるかの確認には使いません。LinuxでRSSを直接読む方法は、後の補足に載せています。
2. 結果をためているリストや辞書の件数を出す
例えば、処理結果をresultsというリストへ追加しているなら、その処理の前後に次を入れます。resultsは自分のコードのリスト名に、run_job()は調べたい処理に置き換えてください。新しく空のリストを作るのではなく、実際に結果をためているものを調べます。
print("処理前の件数:", len(results))
run_job()  # 自分の処理に置き換える
print("処理後の件数:", len(results))
len()は、リストや辞書に入っている要素の数を返します。辞書のcacheへデータを保存しているなら、同じようにlen(cache)を出します。lenの説明
見るのは、使い終わったはずの結果が、処理のたびに追加されて残り続けていないかです。例えば、1回ごとの結果しか使わないのに、過去の結果もリストに追加し続けていたら、その保存が必要かを確認できます。ただし、必要な履歴やキャッシュが増えること自体は異常ではありません。また、件数が同じでも、1件あたりのデータが大きくなれば使用量は増えます。
3. 不要なデータを残していたら直して、同じ条件でもう一度見る
不要な過去の結果を追加し続けない、使い終わった項目をリストから外す、辞書のキャッシュに保持件数や有効期限を設ける、といった変更を検討します。必要なデータまで一括で消すのではなく、何のために残しているかを確認してから直します。
変更前・変更後それぞれで、起動後の初期化を済ませた状態から同じ入力の処理を繰り返します。各回の処理終了直後に、メモリ使用量とリスト・辞書の件数を記録し、「処理のたびに増えていた件数や使用量が、どう変わったか」を比べます。毎回再起動した値どうしで累積増加を判断しないようにします。
今回の実験では、少量でも参照を残している間はGCで変わらず、最後の参照を捨てるとRSSが大きく減りました。ここから持ち帰れるのは、GCを追加する前に、使い終わったデータを自分のリストや辞書が持ち続けていないか確認するという行動です。キャッシュの設計変更による効果まで今回測ったわけではなく、別のアプリでもすぐにRSSが下がると保証するものではありません。
件数に手がかりがない場合は、データ1件の大きさや、ほかの保存先も確認します。それでも増加する場所が分からなければ、次の補足にある詳しい調査へ進みます。件数だけで、すべてのメモリ使用量を説明できるわけではありません。
今回の実験は2周期だけで、途中にGCとtrimも入ります。長期のリーク検出、自然に放置したときの収束、手動GCやtrimを毎リクエスト呼ぶ対策の有効性は検証していません。
補足:増える場所が分からないときは、tracemallocで詳しく調べる
Python側のどこでメモリが増えているかを調べるには、tracemallocで処理前後の記録を比較できます。以下は、調査対象のアプリへ組み込む診断コードの例です。run_same_job()は、同じ入力で実行する自分の処理へ置き換えてください。アプリの初期化を済ませ、比べたい処理に入る前から追跡を開始します。
import tracemalloc

tracemalloc.start()
before = tracemalloc.take_snapshot()

run_same_job()  # 調べたい処理を実行する

after = tracemalloc.take_snapshot()
changes = after.compare_to(before, "lineno")
increases = [change for change in changes if change.size_diff > 0]
for change in increases[:10]:
    print(change)
出力にはファイル名・行番号と、そこから確保されたメモリ量の差が出ます。増分が大きい行を見つけ、その行で作ったデータをどのリストやキャッシュへ渡しているかをコードで追います。表示されるのは「作った場所」であり、「今、参照を保持している場所」が直接分かるわけではありません。tracemallocの比較方法
追跡自体もメモリを使い、開始前の割り当てや、すべてのネイティブ割り当てを把握できるわけではありません。追跡あり・なしのRSSをそのまま比較せず、まずは増えたPython側の割り当てを探すために使います。循環参照が疑われる場合は、前述のNodeのような自己参照がないか、GCの実行記録や回収数も確認します。
Python側の追跡量が戻っているのにRSSだけが残る場合、その事実だけでPythonの参照が残っているとは判断できません。使っているネイティブ拡張や共有ページなども調査候補になります。
補足:Linuxのページ管理と、メモリ指標の読み分け
OSはPythonの変数やリストの要素ではなく、主にページという単位でメモリを扱います。今回の環境では1ページ4 KiBでした。プロセスが使う仮想アドレスは「そのプロセスから見た住所」であり、RAM上の物理ページと対応づけられます。住所の範囲を確保することと、その全域に物理ページを用意することは、同じ時点とは限りません。
たとえば、特定のファイルを裏付けに持たない匿名メモリでは、アクセス時に必要なページを用意する仕組みがあります。確保したサイズだけを見て、同じ量のRAMを使ったとは判断できません。今回の32 MiBのバッファには、ページごとに明示的に書き込みました。Linuxのmallocに関する説明、仮想アドレスへのマッピング
逆に、Python内部でオブジェクトが解放されても、OSにはその「空きブロック」の境界や、Pythonがもう使わないという判断が自動で伝わるわけではありません。OSへ返す操作と、Python内部で再利用可能にする操作を分けて考える必要があります。
仮想アドレスを残したまま、RSSが減ることもある
munmap()は仮想アドレス空間のマッピングを取り除きます。一方、madvise(..., MADV_DONTNEED)では、マッピングを保ったまま、その範囲のページを不要としてカーネルへ伝えられます。匿名のプライベートマッピングでは、後でアクセスするとゼロで満たされたページが再び用意されます。munmap、MADV_DONTNEED
したがって、「OSに戻る」をRSSの減少として見るなら、仮想アドレスの大きさまで同時に減るとは限りません。なお、今回の実験ではシステムコールのトレースはしていません。大きなバッファのRSSがすぐ減ったことだけから、実際にmunmap()が呼ばれたと断定はできません。
指標ごとに数えているものが違う
今回主に見たRSSは、Pythonの生存データ量そのものではありません。コードやスタック、共有ライブラリ、ファイルのマッピングなども含みます。共有ページは各プロセスのRSSへ数えられるため、複数プロセスのRSSを足しても、機械全体の使用量にはなりません。smapsの説明
Linuxには、プロセス群の資源をまとめて管理するcgroupという仕組みもあります。プロセス1個の常駐量、共有分を考慮した量、グループ全体の使用量を分けて見るために、次の指標を使います。
| 指標 | 何を見るか | この実験を読むときの注意 |
|---|---|---|
| 仮想メモリのサイズ | プロセスの仮想アドレス空間の大きさ | その全量がRAMに載っているわけではない |
| RSS | 現在RAMに常駐するプロセスのページ | Pythonの生存オブジェクト以外も含む |
| PSS | 専用ページの全量と、共有ページを共有数で按分した量の合計 | 共有を含めた使用量の比較を助ける |
| Anonymous | ファイルに属さず、現在RAMにあるページの量 | ヒープなどの匿名メモリを見る |
| Swap | スワップへ退避されたメモリの量 | データが生きたままRSSだけ減った可能性を考える材料 |
| cgroupのmemory.current | グループ全体と子グループに課金された使用量 | ページキャッシュやカーネル側の領域等も対象で、RSSとは違う |
Linuxは、オブジェクトが生きていてもスワップなどによりRSSを減らすことがあります。逆に、allocator内部に空きがあってもRSSが残ることがあります。RSSの上下だけでは、Pythonの生存データが増減したのかは分かりません。
コンテナやサービスの上限には、cgroupの指標が必要です。memory.currentはプロセス1個のRSSの代わりではなく、memory.statで匿名メモリ・ファイル由来のメモリ等の内訳を確認できます。memory.maxの上限では、ホスト全体に余裕があっても、そのグループ内でOOM(メモリ不足)が起きる場合があります。cgroup v2のメモリ仕様
また、ホスト全体の「空き」が少なくても、再利用できるページキャッシュが含まれていることがあります。MemAvailableは新しい処理に使える量の見積もりです。これは、今回の匿名メモリのRSS残存を単に「ディスクキャッシュだから」と説明してよいという意味ではありません。LinuxのMemAvailable
Linuxなら、対象プロセスのPIDを指定して次を読み、Rss:の行を記録できます。kB表記なので、MiBへ直すなら1024で割ります。閲覧権限のあるプロセスを指定してください。
pid=12345  # 調べるプロセスのPIDへ置き換える
cat "/proc/$pid/smaps_rollup"
監視画面を使う場合も、現在のRSSかを確認します。ru_maxrssやVmHWMは過去最大なので、処理後に下がるかを見る用途には合いません。Linuxのproc仕様
memory.eventsはOOMなどの発生状況を調べる材料です。プロセスのRSSが横ばいでも、サービス全体のメモリに余裕があるとは限りません。
補足:実験で行ったtracemalloc・malloc_trimの診断
補足として、別プロセスでtracemallocを使った診断も各条件1回行いました。少量保持では、Pythonが追跡する生存メモリの増分が約24.57 MiBから約0.39 MiBへ減っています。これはRSSではなく、追跡対象の割り当て量です。追跡機構自体がRSSを変えるため、本測定のRSSとは別のデータとして扱いました。tracemallocの仕様
各周期の末尾には、glibcのmalloc_trim(0)で空き領域のOSへの返却も試しました。これはGCではなく、allocatorへ返却を促す診断です。今回の通常測定では、GC後や全参照解放後からの大きな追加減少は見られませんでした。全ての空き領域を返す保証はなく、生存参照のあるデータを回収する機能でもありません。malloc_trimの仕様
測定条件・ばらつき・再現用データ
測定プロセスは同時に1個。CPU上限0.25コア、quota period 10 ms、メモリ上限128 MiB、swapの上限0、実行時間上限45秒を設定しました。制御側は別途0.10コア・128 MiBの上限です。負荷監視の中止基準とOOMに到達せず、専用の一時サービス・プロセス・ファイルは測定後に除去済みです。
各周期前にフルGCとmalloc_trim(0)を行い、その時点をRSS増分の基準としました。次の周期は、同じプロセスの直前までの履歴を引き継ぎます。生成前より小さなRSS差分になる観測もあり、これは負のメモリ使用量を意味しません。自動GCは標準設定のままです。
参照破棄から3秒後のRSS増分の範囲は、大きなバッファが0〜+0.016 MiB、小さなバッファが−0.328〜+2.117 MiB、少量保持が+24.398〜+25.852 MiB、循環参照が+29.289〜+30.758 MiBでした。
GCイベントの保存には事前確保した固定長の数値配列を使いました。測定のためのPythonオブジェクトが各所の領域を残す影響を減らすためです。観測処理の小さな割り当てまで、完全にゼロにできているわけではありません。
各段階の数値CSV、約200 ms間隔のRSS時系列CSV、データの読み方を添付します。CSVは内部ホスト情報等を含めず、通常測定とtracemalloc診断を区別しています。
結論:処理後もメモリが高いなら、まずデータをためていないか確認する
今回の実験では、データを98%以上捨てても、少量の参照が残っている間はGCを動かしてもRSSがほとんど減りませんでした。最後の参照も捨てると、大きく減りました。
Pythonのアプリで同じようにメモリが下がらないときは、まず次の3つを試します。
- 同じPythonを起動したまま同じ処理を繰り返し、終了直後のメモリ使用量をメモする。 普段の監視画面の同じ項目で、毎回増えるかを見ます。
- 結果をためるリストや辞書の件数を、処理の前後に
print(len(...))で出す。 使い終わったデータが、処理のたびに残り続けていないかを確かめます。 - 不要な保存を見つけたら直し、同じ条件でもう一度比べる。 件数とメモリ使用量の増え方がどう変わったかを見ます。
最初の「メモリが減らないとき、何を調べればよいのか」への答えは、処理後の数字を繰り返し記録し、使い終わったデータを入れたままのリストや辞書がないか調べることです。すぐにメモリ使用量が下がらなくても、それだけで修正の失敗とは言えません。件数に手がかりがない場合や、修正後も増加が続く場合は、補足の詳しい調査へ進みます。
KamuiDashについて
KamuiDashは、GitHubからWebアプリをデプロイできる、日本リージョン対応のPaaSです。