
我們用Python建立80,000個小型資料,移除超過98%的參照後,發現有一種情況的記憶體用量幾乎沒有下降。
「移除參照」是切斷變數或list與資料之間的連結;垃圾回收(GC)則是回收程式已無法再使用的資料。其他變數或list仍能存取的資料,即使執行GC也不會被回收。
我們只保留每64個物件中的1個參照。手動執行GC後,用量仍幾乎不變;但連最後這些參照也移除時,用量就大幅下降。
移除了大部分資料、執行GC,用量仍不下降,放開最後少量資料卻下降了。這個結果提供了一個線索:應該把「資料已經用完」與「OS看到的記憶體用量下降」分開思考。
本文透過4個條件,理解當時還留下了什麼,再回答工作結束後記憶體用量不下降時,該從哪裡查起。
這次測量的指標是RSS(Resident Set Size,常駐記憶體大小):執行中的程式(行程)所對應的記憶體中,目前實際駐留在實體記憶體(RAM)裡的量。它包含Python資料,也包含程式碼、共享函式庫等,因此不等於「仍存活的Python資料量」。Linux對RSS的說明
實驗出現3種結果:移除參照後RSS立刻下降、等到GC回收才下降,以及因為仍保留少量參照,即使GC也不下降。以下把這些差異連結到工作結束後的記憶體調查順序。
比較4個條件:移除參照後的記憶體變化
測試使用CPython 3.11.2、Linux 6.12、aarch64與glibc 2.36,啟用Python標準的小型配置管理機制pymalloc,比較下列4個條件。
| 條件 | 建立的資料 | 「丟棄」的操作 |
|---|---|---|
| 大型緩衝區 | 1個32 MiB的bytearray | 移除其參照 |
| 小型緩衝區 | 80,000個bytearray(256) | 丟棄整個list |
| 少量保留 | 同樣的80,000個緩衝區 | 每64個保留1個,共1,250個,存入另一個list |
| 循環參照 | 80,000個Node,各自持有自身參照與bytearray(256) | 丟棄外層list |
這裡的256是bytearray內容的位元組數。物件與list本身也需要管理空間,因此80,000×256位元組不會直接等於RSS增量。
每個條件都以全新的行程測量3次,每個行程內再重複2個週期。移除參照後立刻、1秒後與3秒後記錄記憶體,接著執行gc.collect()。少量保留的條件,之後也會釋放剩餘參照。
實驗發現:同樣是「丟棄」,歸還方式卻不同
| 條件 | 建立後 | 移除參照後立刻 | 3秒後 | 手動GC後 | 剩餘參照也釋放後 |
|---|---|---|---|---|---|
| 大型緩衝區 | +32.00 | +0.00 | +0.01 | +0.01 | +0.01 |
| 小型緩衝區 | +25.87 | +0.86 | +0.86 | +0.84 | +0.84 |
| 少量保留 | +25.90 | +25.61 | +25.61 | +25.61 | +0.45 |
| 循環參照 | +30.32 | +30.02 | +30.02 | +0.90 | +0.90 |
單位為MiB,數值是相對於各週期建立資料前的RSS增量中位數。1 MiB等於1,048,576位元組。這裡彙整3個行程×2個週期的6筆觀測,但不把同一行程內的2個週期視為獨立重複。
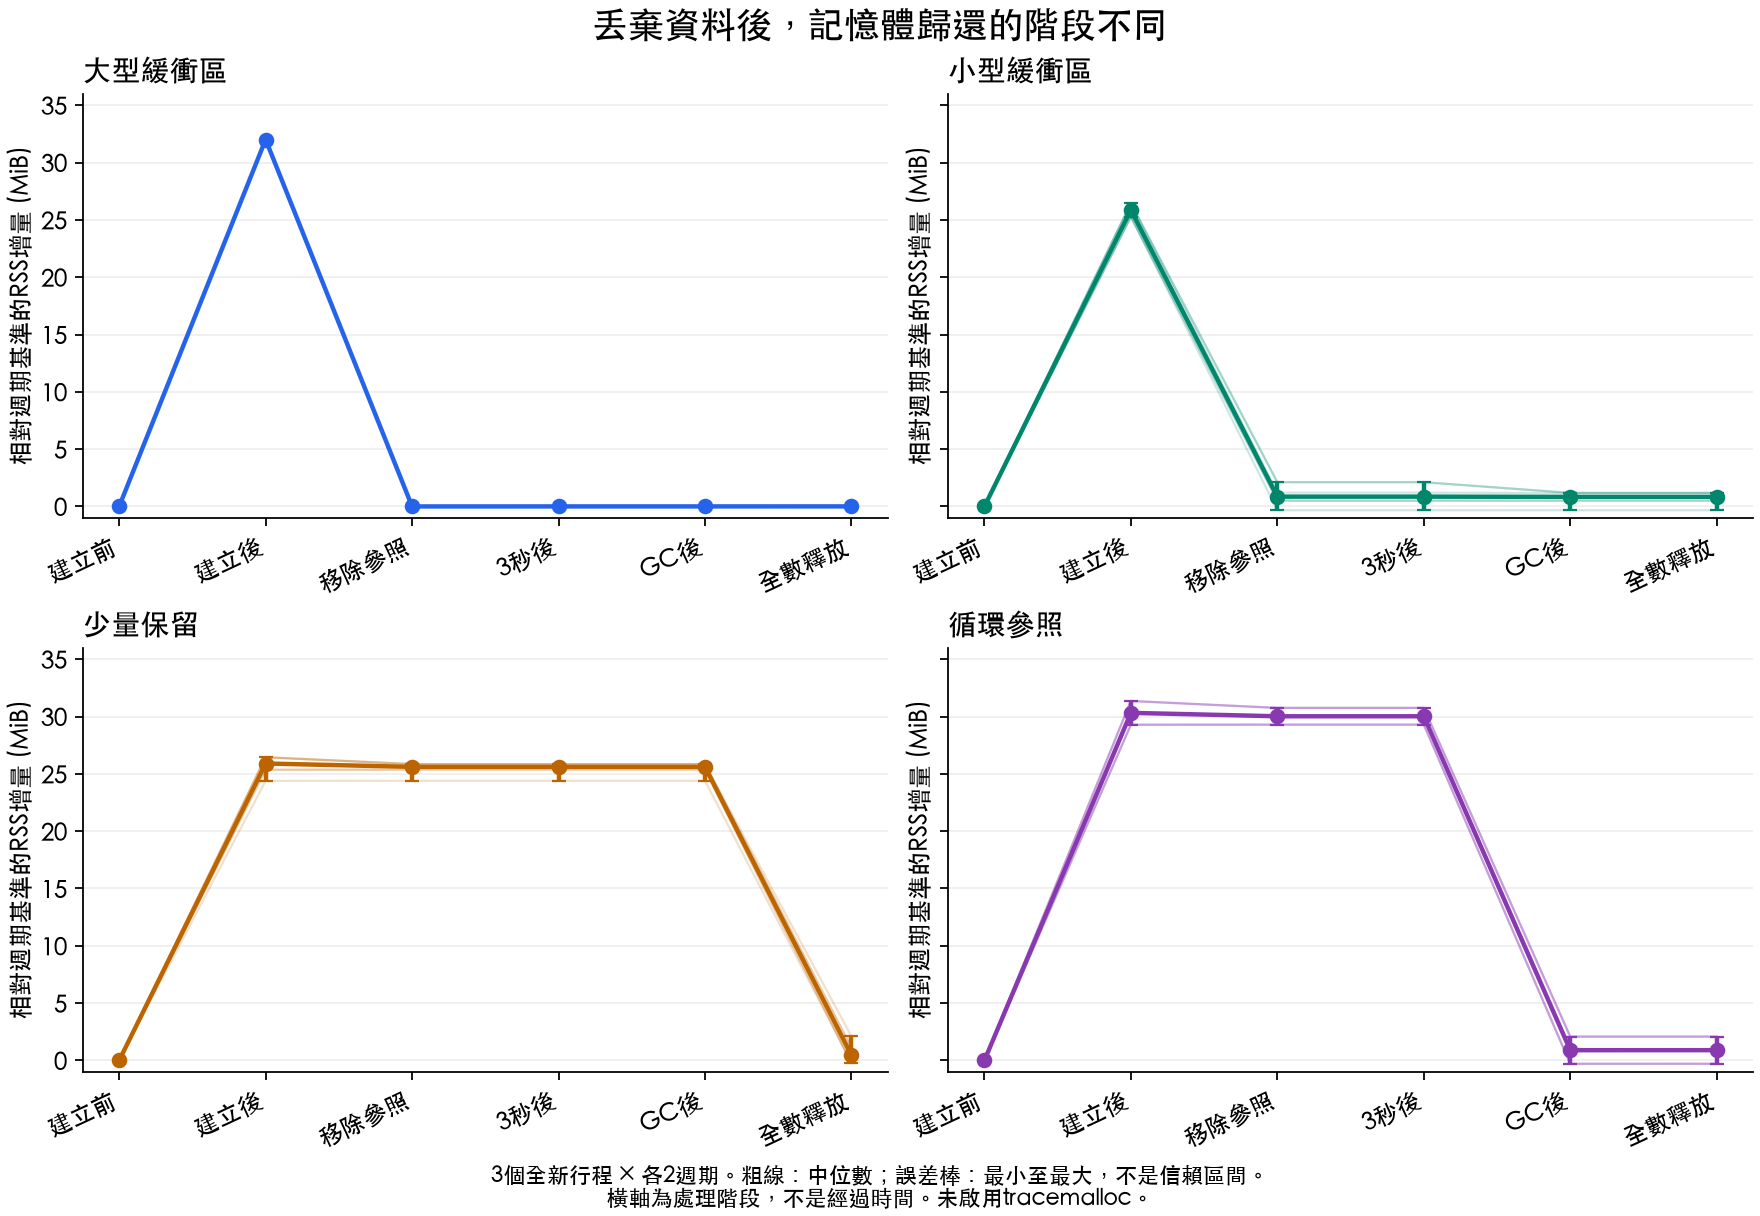
表格顯示,資料「丟棄」之後還需要做什麼,會因參照狀態而不同。
- 單一32 MiB大型緩衝區移除參照後,RSS增量立刻幾乎回到0。小型緩衝區在移除全部參照時,也立刻減少了大部分增量。
- 循環參照等待3秒後,仍留下約30.02 MiB增量;手動GC後降到約0.90 MiB。
- 小型緩衝區每64個保留1個,約1.6%,即使GC後仍留下約25.61 MiB增量。移除最後的參照後,降到約0.45 MiB。
「等一段時間就會下降」或「執行GC就會下降」,都無法解釋全部情況。 尤其是,丟棄超過98%的資料,不代表RSS也會按相同比例下降。接著從記憶體管理機制來理解原因。
為什麼不同:參照、回收與歸還OS要分開看
- 1. 物件生命週期
參照計數與循環GC回收不再需要的Python物件。
觀察:參照、GC回收數、Python追蹤配置量 - 2. 配置器內的空閒空間
配置器可把空閒區塊用於下一次配置。
例如pymalloc與glibc;路徑隨大小等條件而異。 - 3. OS看到的常駐頁面
對應到行程的實體頁面減少時,RSS也會下降。
觀察:RSS、PSS、Anonymous、Swap
Python回收物件後,原本供該物件使用的空間就能再次使用。但如果管理配置的機制,也就是配置器(allocator),仍保留這些空間,OS看到的常駐記憶體不一定會立刻下降。Python記憶體管理文件說明了Python內部多種配置與快取機制。
循環參照沒有因為等待3秒就被回收
CPython使用參照計數回收物件,再由尋找循環參照的GC補足。例如下列Node就持有對自己的參照。
class Node:
    def __init__(self):
        self.link = self
        self.payload = bytearray(256)

nodes = [Node() for _ in range(80_000)]
del nodes  # 外層list消失,但每個Node仍參照自己。
這是用來說明關係的簡化範例。實際測量的程式還固定了其他細節,例如使用__slots__,避免另外建立屬性用的dict。
在循環參照條件中,我們先讓外層list持有所有Node,執行一次完整GC,確認回收數為0。這次預先GC也會改變物件所屬的世代。 接著移除外部參照,3秒後RSS仍幾乎不變,取樣追蹤的32個物件也全都存活。
手動GC每次都回收80,000個Node,取樣物件則全數消失。RSS增量的中位數也從約30.02 MiB降到約0.90 MiB。回收數是Node的個數,不是附帶bytearray的個數。
自動GC保持啟用,但從移除參照到3秒後,觀測到的GC事件數沒有增加。CPython 3.11以配置與釋放計數判定自動GC的觸發時機,不是單靠經過幾秒來決定。這次測試也在預先GC後,幾乎不執行新工作,只等待。GC規格
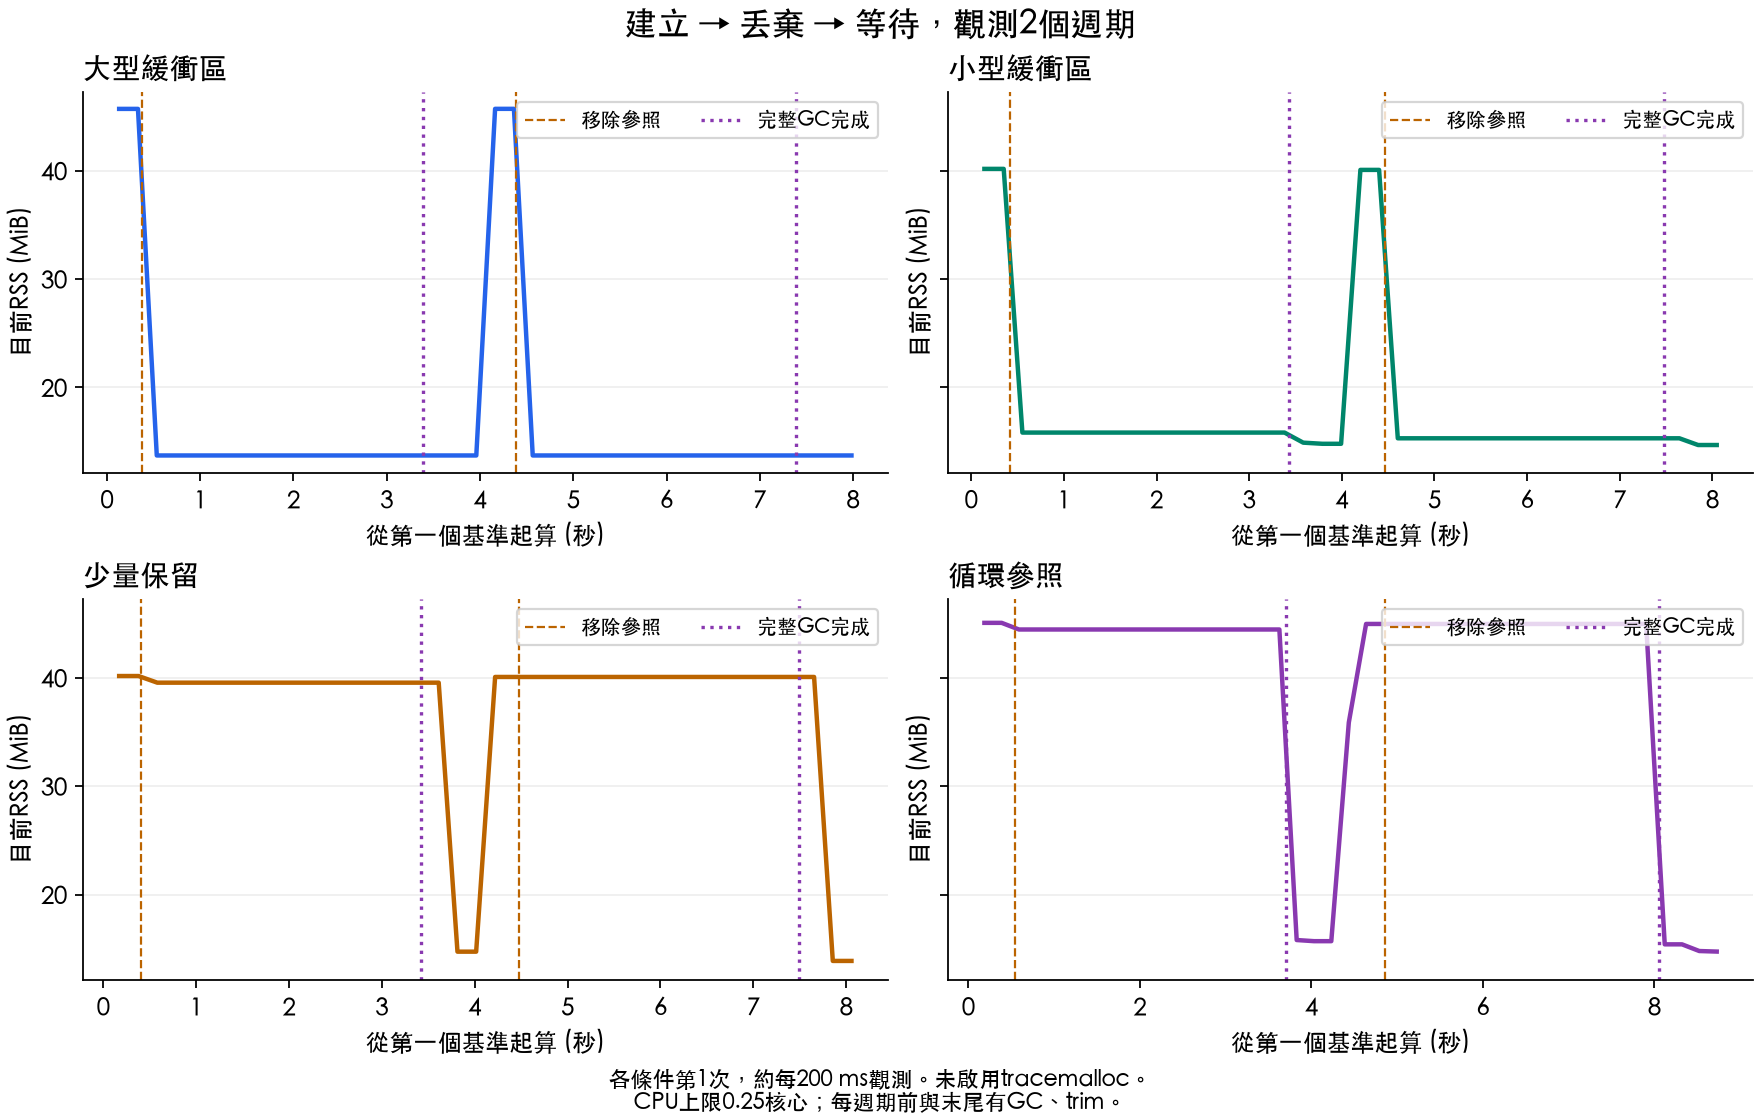
手動GC經過時間的中位數為146.9 ms,行程CPU時間為38.8 ms。CPU上限設為0.25核心,經過時間也包含無法使用CPU而等待的時間,不能直接當作正式應用程式的GC暫停時間。
為什麼只保留約1.6%,卻留下更大的區域?
少量保留條件把80,000個物件中的1,250個留在list裡。GC不能任意丟棄仍有有效參照的物件,但保留的緩衝區只占原本數量與內容量的約1.6%。RSS似乎也該縮到差不多的比例,這次卻沒有觀察到。
pymalloc處理512位元組以下的小型配置,在64位元平台使用大小為1 MiB、稱為arena的區域,裡面再容納更小的配置。空閒區塊能重複使用,與整個arena能歸還,是兩件事。pymalloc規格
整個區域都空閒時,才成為可歸還的候選。
要保留原位置的存活資料,就無法直接丟棄整個區域。
空閒區塊 存活物件
釋放最後的參照後,RSS大幅減少,與這種區域保留方式相符。不過,我們沒有觀察所有arena的配置,也沒有比較其他配置器,因此不能把全部殘留RSS都歸因於某個特定的內部結構。
下次記憶體用量不下降時,依這個順序確認
先從平常使用的記憶體監控畫面,以及Python的print()開始。在開發環境中,同時觀察工作結束後的記憶體用量,與程式留下的資料筆數。
1. 重複相同工作,記下記憶體數字
在OS的行程列表或平常使用的應用程式監控畫面中,找到要調查的Python行程,查看記憶體用量。不知道是哪個行程時,可以在要調查的Python程式裡執行以下程式碼,取得行程編號(PID)。os.getpid說明
import os
print("這個Python的PID:", os.getpid())
保持這個Python行程執行,以相同輸入、相同工作量重複幾次,每次都在工作結束後立刻記下記憶體用量。觀察「最初增加後就大致持平」,還是「每次執行都增加」。不要把每次都結束Python再重新啟動的數值混入比較,因為結束行程也會移除先前累積的內容。只有幾次持平,也不能確定沒有記憶體洩漏。
比較時,使用同一個畫面的同一個欄位。監控畫面的「記憶體」不一定是RSS,不需要把其絕對值與本文的RSS測量值比較。另外,「最高用量」是歷史最大值,不能用來判斷工作結束後的目前用量是否下降。後面的補充會說明如何在Linux直接讀取RSS。
2. 印出存放結果的list或dict筆數
例如,程式把處理結果加入名為results的list,就在該處理前後加入下列程式碼。把results換成自己的list名稱,把run_job()換成要調查的處理。要查看實際存放結果的list,不是另外建立一個空list來檢查。
print("處理前的筆數:", len(results))
run_job()  # 換成自己的處理。
print("處理後的筆數:", len(results))
len()會回傳list或dict的元素數量。若把資料存進名為cache的dict,也同樣印出len(cache)。len說明
要看的是:已經用完的結果,是否每次處理後都繼續被加入並留下來。例如只需要當次結果,卻不斷把過去結果加入list,就可以確認這種保存是否必要。不過,必要的歷史紀錄或快取增加,本身不代表異常。即使筆數相同,每筆資料變大也會增加用量。
3. 找到不必要的保留後修正,再用相同條件比較
可以考慮不再持續加入不需要的過去結果、用完後把項目移出list,或為dict快取設定保留筆數與有效期限。先確認保留資料的目的,再修改程式,不要把仍需要的資料也一併刪除。
修改前與修改後,都從啟動並完成初始化的狀態開始,以相同輸入重複相同工作。每次工作結束後立刻記錄記憶體用量,以及相關list或dict的筆數,比較「原本每次都增加的筆數與用量,變化方式有何不同」。不要用每次重新啟動後的數字,判斷是否逐次累積。
這次實驗中,即使只保留少量參照,GC也沒有改變結果;移除最後的參照,RSS才大幅下降。因此可以帶走的行動是:加入GC呼叫前,先確認自己的list或dict是否仍持有已經用完的資料。這次沒有測量調整快取設計的效果,也不保證其他應用程式的RSS會立刻下降。
如果筆數沒有提供線索,再確認單筆資料大小與其他保存位置。仍找不到增加的位置時,再進入下面補充的詳細調查。光靠筆數,無法解釋所有記憶體用量。
這次只有2個週期,中途也執行GC與trim,因此沒有驗證長期洩漏或自然閒置時的收斂情況,也沒有驗證每個請求都呼叫GC或trim是否能解決問題。
補充:找不到增加位置時,再用tracemalloc詳細調查
要確認Python端的記憶體在哪裡增加,可以用tracemalloc比較處理前後的紀錄。以下是放進待調查應用程式的診斷範例,請把run_same_job()換成使用相同輸入的自有處理。先完成應用程式初始化,並在要比較的處理開始前啟用追蹤。
import tracemalloc

tracemalloc.start()
before = tracemalloc.take_snapshot()

run_same_job()  # 換成要調查的處理。

after = tracemalloc.take_snapshot()
changes = after.compare_to(before, "lineno")
increases = [change for change in changes if change.size_diff > 0]
for change in increases[:10]:
    print(change)
輸出包含檔名、行號,以及從該位置配置的記憶體量差值。先找到增量較大的行,再從程式碼追查那裡建立的資料被傳到哪個list或快取。顯示的是「建立位置」,不會直接告訴你「現在是哪裡持有參照」。tracemalloc比較方法
追蹤本身也會使用記憶體,無法掌握開始追蹤前的配置,也不是所有原生配置都能追蹤。不要直接比較啟用與未啟用追蹤的RSS;先用它找出增加的Python端配置。如果懷疑循環參照,再確認是否有前文Node那樣的自我參照,以及GC事件與回收數。
如果Python追蹤量已回落,只有RSS仍高,不能只憑這點就判定Python參照仍然存在。使用中的原生擴充與共享頁面等,也可能需要調查。
補充:Linux頁面管理與記憶體指標的區別
OS主要以頁面(page)為單位管理記憶體,而不是以Python變數或list元素為單位。這次環境的頁面大小是4 KiB。行程使用的虛擬位址,是該行程看到的「地址」,可以對應到RAM中的實體頁面。保留一段位址範圍,與為整個範圍準備實體頁面,不一定在同一時間發生。
以沒有特定檔案作為後盾的匿名記憶體為例,Linux可以在存取時才準備所需頁面。只看配置大小,無法判定用了多少RAM。因此這次對32 MiB的緩衝區逐頁明確寫入。Linux的malloc說明、虛擬位址映射
反過來說,Python內部回收物件後,OS不會自動得知那些「空閒區塊」的邊界,或Python已經不再需要它們。讓空間能在Python內部重複使用,與把它還給OS,是不同的操作。
虛擬位址仍保留時,RSS也可能下降
munmap()會移除虛擬位址空間中的映射。相對地,madvise(..., MADV_DONTNEED)可以保留映射,同時告知核心某段範圍的頁面已不再需要。對私有匿名映射而言,之後再存取時,會重新提供填滿零的頁面。munmap、MADV_DONTNEED
所以,如果把RSS下降視為「還給OS」,虛擬記憶體大小不一定也會同時縮小。這次沒有追蹤系統呼叫,不能只憑大型緩衝區的RSS立刻下降,就斷定實際呼叫了munmap()。
不同指標,計算的東西不同
這次主要觀察的RSS,不等於Python存活資料的大小,也包含程式碼、堆疊、共享函式庫、檔案映射等。共享頁面會計入每個行程的RSS,因此把多個行程的RSS相加,並不等於整台機器的記憶體用量。smaps說明
Linux還有cgroup,用來統一管理一組行程的資源。下列指標分別觀察單一行程的常駐量、考慮共享後的用量,以及整個群組的使用量。
| 指標 | 觀察什麼 | 閱讀這次實驗時的注意事項 |
|---|---|---|
| 虛擬記憶體大小 | 行程的虛擬位址空間大小 | 不代表全部都在RAM裡 |
| RSS | 目前駐留RAM的行程頁面 | 不只包含Python存活物件 |
| PSS | 私有頁面全量,加上按共享數分攤的共享頁面量 | 協助比較包含共享部分的用量 |
| Anonymous | 不屬於檔案、目前位於RAM的頁面量 | 觀察heap等匿名記憶體 |
| Swap | 被移至swap的記憶體量 | 判斷資料仍存活、但RSS已下降的可能性 |
| cgroup的memory.current | 計入該群組與子群組的使用量 | 也包含頁面快取與核心記憶體等,與RSS不同 |
即使物件仍存活,Linux也可能透過swap等機制降低RSS。反過來,即使配置器內部有空閒空間,RSS也可能維持高檔。單靠RSS升降,無法判定Python存活資料是否增減。
若要確認容器或服務的上限,還需要看cgroup指標。memory.current不是單一行程RSS的替代品;memory.stat能提供匿名記憶體、檔案相關記憶體等細項。即使主機整體仍有餘裕,群組也可能因memory.max上限而發生OOM(記憶體不足)。cgroup v2記憶體規格
主機顯示的「完全空閒」記憶體不多時,仍可能有可再利用的頁面快取。MemAvailable估算新工作可使用的記憶體量,但這不代表這次匿名記憶體的RSS殘留,可以一概解釋成磁碟快取。Linux的MemAvailable
在Linux可以指定目標行程的PID,讀取下列輸出的Rss:欄位。單位標為kB,要換成MiB請除以1024。請指定有權檢視的行程。
pid=12345  # 換成要調查的行程PID。
cat "/proc/$pid/smaps_rollup"
使用監控畫面時,也要確認顯示的是目前RSS。ru_maxrss與VmHWM是歷史最高值,不適合用來判斷工作結束後的目前用量是否下降。Linux的proc規格
memory.events可協助調查OOM等事件。行程RSS持平,不代表整個服務的記憶體一定還有餘裕。
補充:實驗中的tracemalloc與malloc_trim診斷
另外也使用tracemalloc,以不同的行程對每個條件各做1次診斷。少量保留時,Python追蹤到的存活配置增量從約24.57 MiB降到約0.39 MiB。這是追蹤配置量,不是RSS;追蹤機制本身會改變RSS,因此這批診斷資料與主要RSS測量分開處理。tracemalloc規格
每個週期末尾,也用glibc的malloc_trim(0)嘗試把空閒空間還給OS。這是針對配置器的診斷,不是GC。在未啟用追蹤的主要測量中,GC後或釋放全部參照後,trim沒有帶來大幅的額外下降。它不保證歸還所有空閒空間,也無法回收仍有存活參照的資料。malloc_trim規格
測量條件、變動範圍與重現用資料
測量行程同時只執行1個,設定CPU上限0.25核心、quota period 10 ms、記憶體上限128 MiB、swap上限0,以及45秒執行時間上限。控制端另有0.10核心與128 MiB的上限,沒有達到負載監控的停止條件或發生OOM。測量後已移除專用的暫存服務、行程與檔案。
每個週期開始前執行完整GC與malloc_trim(0),並以當下為RSS增量基準。下一個週期會沿用同一行程先前的歷史狀態。有些差值會低於基準,並不代表記憶體用量為負數。自動GC保留標準設定。
移除參照3秒後,RSS增量範圍為:大型緩衝區0〜+0.016 MiB、小型緩衝區−0.328〜+2.117 MiB、少量保留+24.398〜+25.852 MiB、循環參照+29.289〜+30.758 MiB。
GC事件記錄使用預先配置、固定大小的數值陣列,以減少測量用物件散布在各配置區域、導致區域被保留的影響。但觀測本身的小型配置並未完全消除。
附上各階段數值CSV、約每200 ms取樣的RSS時序CSV,以及資料閱讀指南。CSV不含內部主機資訊,並區分主要測量與tracemalloc診斷。
結論:工作結束後記憶體仍高,先確認是否持續累積資料
這次實驗中,即使丟棄超過98%的資料,只要仍有少量參照,執行GC後RSS也幾乎不下降。移除最後的參照後,用量才大幅下降。
Python應用程式遇到類似情況時,可以先做以下3項確認。
- 保持同一個Python行程執行,重複相同工作,記下每次結束後的記憶體用量。 在平常的監控畫面使用同一欄位,觀察是否每次都增加。
- 在處理前後,用
print(len(...))印出存放結果的list或dict筆數。 確認已經用完的資料,是否每次處理後仍持續留下來。 - 找到不必要的保存後修正,再用相同條件比較。 觀察筆數與記憶體用量的增加方式有何改變。
對於最初的「記憶體不下降時,該查什麼」,答案是反覆記錄工作結束後的數字,並確認是否有list或dict仍放著已經用完的資料。記憶體用量沒有立刻下降,不代表修正失敗。如果筆數沒有線索,或修改後仍持續增加,再進入補充的詳細調查。
關於KamuiDash
KamuiDash是支援日本區域的PaaS,可直接從GitHub部署Web應用程式。