
Web應用程式偶爾回應很慢。查看CPU用量圖,卻發現連設定上限的一半都沒用到。「CPU明明還有餘裕,到底在哪裡等待?」這時,很容易不知道該往哪裡查。
這次想確認的是:請求數量相同,只是在短時間內集中到達,是否就會讓回應變慢? 我們也比較了提高CPU上限後,這種延遲會不會改變。
我們讓每次都執行相同計算的API,分別接收固定間隔與成批送出的請求。CPU上限設為0.25核心時,兩者的平均用量都不到上限的一半,但用來比較較慢回應的數值,卻分別約為10毫秒與202毫秒。
藉由這個結果,看看即使CPU平均用量不高,還有哪些資訊值得確認。
同樣每秒20次請求,比較均勻發送與成批發送
實驗用API每次收到請求,都執行相同的計算。我們先調整到計算約使用4毫秒的CPU時間,再固定計算次數。CPU時間是實際使用CPU工作的時間,不是包含等待在內的經過時間。
發送方式有兩種,以下將一次存取稱為「請求」。
- 均勻發送: 每50毫秒1次,每秒20次。
- 成批發送: 每400毫秒8次,平均也是每秒20次。
CPU上限分別設為0.25核心與0.5核心。這是以持續使用1個核心為基準,限制可用CPU時間的設定。具體如何限制,稍後會再說明。
總共4種條件,每種量測20秒,改變順序重複3次。每種條件1,200次,合計4,800次請求全部成功。通訊都在同一台機器內進行,不包含外部網路或資料庫存取。
CPU平均用量幾乎相同,回應時間卻不同
為了也比較較慢的回應,我們把每種條件的1,200筆回應時間由短到長排序,取位於整體99%位置的第1,188筆時間。它不是平均時間,也不是最慢的那一筆。表格與圖中稱為「較慢回應的比較值」。單位ms是毫秒,1,000ms等於1秒。
| CPU上限 | 發送方式 | 平均CPU用量 | 占上限比例 | 較慢回應的比較值 |
|---|---|---|---|---|
| 0.25核心 | 均勻 | 0.103核心 | 41.2% | 10.1ms |
| 0.25核心 | 成批 | 0.108核心 | 43.3% | 202.2ms |
| 0.5核心 | 均勻 | 0.107核心 | 21.4% | 10.1ms |
| 0.5核心 | 成批 | 0.106核心 | 21.2% | 104.2ms |
回應時間合併每種條件的全部1,200筆計算;CPU用量則是3次量測的平均。「占上限比例」是相對於設定的CPU上限,不是整台機器的容量。
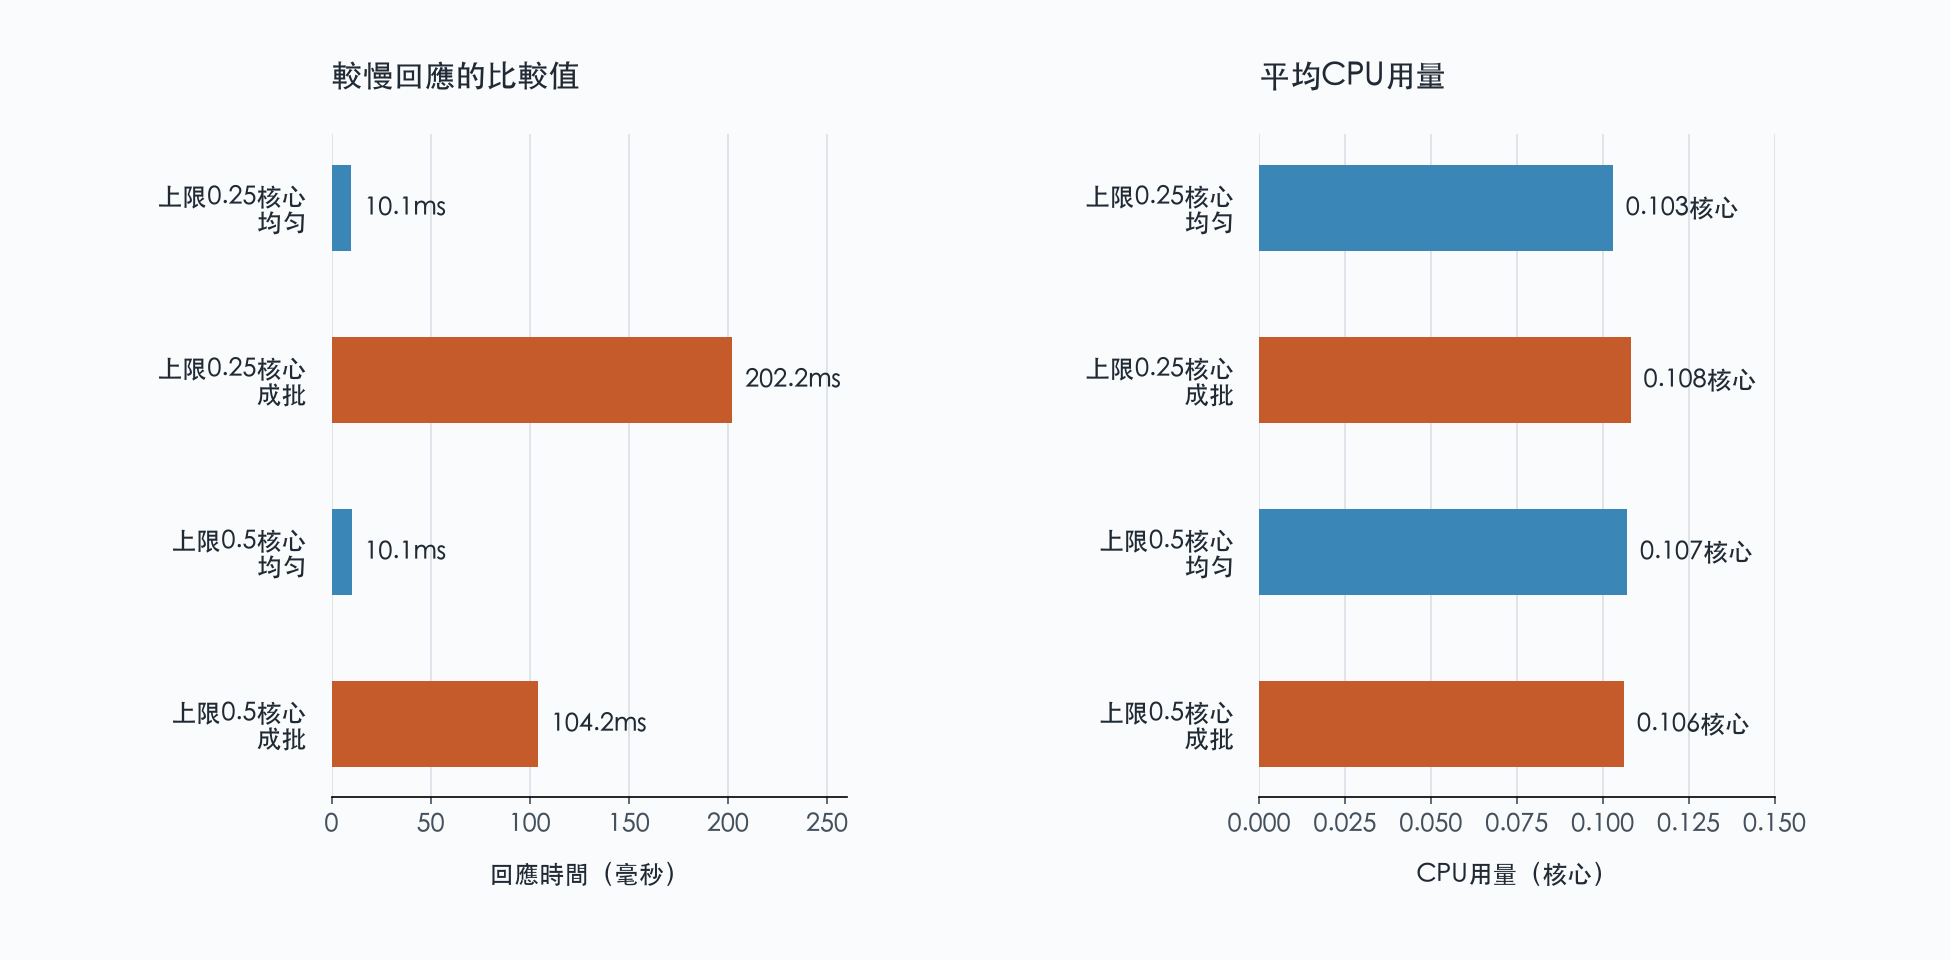
0.25核心的條件下,兩種發送方式的CPU平均用量都不到上限的一半。可是,成批發送後,比較值卻從10.1ms變成202.2ms,約為20倍。
接著保持發送方式不變,把CPU上限提高到0.5核心,成批發送的比較值縮短到104.2ms。均勻發送則仍約為10ms。在這次條件下,提高CPU上限的效果,出現在請求集中到達的情況。
3次量測中,成批發送的比較值在0.25核心時為144.3〜203.4ms,在0.5核心時為69.8〜105.9ms。每次的數值不完全相同,但3次都是成批發送較慢,這個趨勢沒有改變。
為什麼不能使用看似空閒的CPU?
這次使用的Linux CPU限制,並不是讓CPU一直以四分之一的速度運作,而是在每個短週期內,規定可以使用多少CPU時間。
在0.25核心的條件下,讀到的cpu.max檔案內容是25000 100000。單位為微秒,表示每100毫秒的週期,總共可以使用25毫秒的CPU時間。限制套用在包含應用程式的整個群組,不是每筆請求各有25毫秒。Linux核心官方文件說明了設定格式與限制的統計資訊。
=需要約32毫秒CPU時間
應用程式仍可能受到CPU限制
每筆計算約4毫秒,8筆合計就需要約32毫秒的CPU時間,還要加上HTTP等處理。因此,工作在短時間內集中時,就可能用完該週期的CPU時間額度。
另一方面,約20秒的平均也包含沒有請求進來的時間。長時間平均看起來還有餘裕,請求集中的短時間內卻仍可能碰到CPU限制。這就是只看平均值容易漏掉的部分。
也確認了CPU確實受到限制的紀錄
我們沒有只靠原理推斷,也檢查了Linux留下的紀錄。cpu.stat檔案中的nr_throttled,記錄因用完CPU時間額度而受到限制的週期數。我們在每次量測前後讀取數值,再把3次的增量加總。
| CPU上限 | 發送方式 | 發生限制的週期數 |
|---|---|---|
| 0.25核心 | 均勻 | 0 |
| 0.25核心 | 成批 | 202 |
| 0.5核心 | 均勻 | 0 |
| 0.5核心 | 成批 | 50 |
這是3次量測前後增量的合計,不是變慢的請求數,也不是等待的毫秒數。
均勻發送時,計數沒有增加;成批發送時,兩種CPU上限下都增加了。也就是說,即使CPU平均用量不高,CPU限制仍確實發生過。
不過,光靠這項紀錄,無法知道個別請求等了多少毫秒。這次的Python伺服器也有限制可同時執行多少計算的特性,等待先前工作完成、切換執行工作等因素也會影響回應時間。我們沒有與不設CPU上限的條件比較,因此不能把約20倍的差距全部歸因於CPU限制。
自己的應用程式遇到相同情況時,該查什麼?
最初的疑問是:「CPU明明有餘裕,到底在哪裡等待?」這次確認的是,即使CPU平均用量低,請求集中時仍可能受到CPU限制,並出現較慢的回應。只看平均用量圖,還不能把CPU相關問題排除。
自己的應用程式出現類似情況時,可以依序確認:
- 查看變慢時刻的請求。從平常使用的回應時間紀錄或存取日誌,找出發生慢回應的時段。不要只看每分鐘總數,也看時間戳記:請求是否集中在同一秒,或一秒內更短的時間?如果只留下粗略時間,就無法判斷更短的集中情況。
- 查看同一時段,CPU限制的紀錄是否增加。如果監控畫面有「CPU throttling/CPU節流」項目,它反映因CPU上限而暫停執行的情況,可以與變慢時段比對。能查看Linux執行環境時,也可以在前後讀取應用程式所屬群組的
cpu.stat,確認nr_throttled增量。找不到時,直接詢問維運人員「這個時段,應用程式是否碰到CPU限制?」也可以。 - 如果限制與變慢同時發生,就在開發環境只改CPU上限來比較。固定請求數、集中方式與每筆工作內容,比較回應時間及限制紀錄如何變化。這次提高上限後,成批發送的回應縮短,均勻發送卻幾乎不變。先確認自己應用程式的效果,再決定是否調整上限。
如果提高CPU上限仍沒有改善,再調查資料庫查詢、外部通訊等其他等待。即使限制紀錄沒有增加,也可能是看錯群組,或上層群組另有不同限制,還不能直接下結論。
不要停在「CPU還有空,所以無關」,而是把慢回應的時刻、請求集中情況與CPU限制紀錄放在一起確認。這次實驗提供的是決定下一步調查方向的方法。
量測條件與結果解讀
回應時間從預定發送時刻,量到完整讀取回應本文為止,也包含發送程式比預定時間晚開始的延遲。這項開始延遲位於整體99%位置的數值,依條件約為1.1〜5.7毫秒。
發送時刻事先決定,不等待前一筆回應,避免回應變慢時,發送數量也跟著減少,讓集中負載變弱。
- 環境:Linux、4個邏輯CPU、cgroup v2;共用機器上也有其他工作執行。
- 伺服器:Python 3.11的ThreadingHTTPServer,HTTP/1.1重用連線,啟用TCP_NODELAY。
- 計算:每筆請求執行5,025次SHA-256。量測前校準時,計算CPU時間的中位數約4.0毫秒。
- 發送:同一台機器內最多8筆並行;每50毫秒1筆,或每400毫秒8筆。
- CPU上限:0.25/0.5核心,週期100毫秒;量測對象的上層群組沒有額外CPU頻寬限制。
- 量測:每種條件20秒、重複3次,改變順序。每次重新啟動伺服器,排除暖機資料。
- 回應時間彙整:每種條件1,200筆由短到長排序的第1,188筆。單次量測取400筆中的第396筆;本文範圍是3次的最小至最大值。
- CPU用量彙整:把
cpu.stat的usage_usec增量換算成秒,除以CPU觀測秒數,再計算3次的平均。
CPU觀測比預定開始發送早約0.1秒,因此分母約為20.101秒,與CSV的duration_s(從預定發送開始起算的約20秒)不同。runs.csv包含從CPU用量反推的觀測時間,以及其他時間紀錄得到的近似值。詳見資料補充說明。
這次使用的CPython 3.11有GIL機制,會限制多個執行緒同時執行Python程式碼的範圍,詳見Python官方文件。其他工作與執行順序的影響並未分離;即使計算次數固定,實際CPU時間仍有變動。這項實驗並不表示其他機器或應用程式也會得到相同時間與倍數。
量測資料與實驗程式
重現用程式適用於能透過systemd使用者服務設定CPU限制的Linux環境。
部署你的Web應用程式
想把GitHub上的Web應用程式部署到日本區域嗎?KamuiDash可以從儲存庫部署應用程式。