
Webアプリの応答が、ときどき遅くなる。CPU使用量のグラフを見ると、設定した上限の半分も使っていない。「CPUには余裕があるのに、どこで待っているのか」と調べる手が止まってしまいます。
ここで確かめたかったのは、アクセスの件数が同じでも、短い時間に集中するだけで応答が遅くなるのかです。さらに、CPUの上限を増やすと、その遅さが変わるかも比べました。
同じ計算をするAPIに、一定の間隔でアクセスする場合と、まとめてアクセスする場合を用意しました。CPUの上限を0.25コアにしたところ、どちらも平均の使用量は上限の半分未満。それでも、遅い応答を比べると、約10ミリ秒と約202ミリ秒の差が出ました。
この結果から、CPUの平均値に余裕があるときでも、何を確認すればよいかを考えます。
同じ毎秒20件を、均等に送る場合とまとめて送る場合で比べる
実験用のAPIは、1件のアクセスにつき毎回同じ計算をします。計算に約4ミリ秒のCPU時間を使うように調整し、その後は計算回数を固定しました。CPU時間は、待ち時間を含む経過時間ではなく、実際にCPUで計算した時間です。
アクセスの送り方は次の2つです。ここからは、1回のアクセスを「リクエスト」と呼びます。
- 均等に送る: 50ミリ秒ごとに1件。毎秒20件。
- まとめて送る: 400ミリ秒ごとに8件。こちらも平均すると毎秒20件。
CPU上限は0.25コアと0.5コアの2種類にしました。これは、1コアを使い続けた場合を基準に、使えるCPU時間を制限する設定です。どのような制限なのかは、後で具体的に見ます。
計4条件を各20秒、順序を変えて3回ずつ測定しました。1条件1,200件、合計4,800件はすべて成功しています。通信は同じマシン内で行い、外部ネットワークやデータベースへのアクセスは含めていません。
CPUの平均使用量はほぼ同じでも、応答時間は変わった
一部の遅い応答も比べたいので、各条件1,200件の応答時間を短い順に並べ、全体の99%に当たる1,188番目の時間を使います。平均時間や最も遅い1件の時間ではありません。表と図では、これを「遅い応答の比較値」と呼びます。単位のmsはミリ秒で、1,000msが1秒です。
| CPU上限 | 送り方 | 平均CPU使用量 | 上限の何%か | 遅い応答の比較値 |
|---|---|---|---|---|
| 0.25コア | 均等 | 0.103コア | 41.2% | 10.1ms |
| 0.25コア | まとめて | 0.108コア | 43.3% | 202.2ms |
| 0.5コア | 均等 | 0.107コア | 21.4% | 10.1ms |
| 0.5コア | まとめて | 0.106コア | 21.2% | 104.2ms |
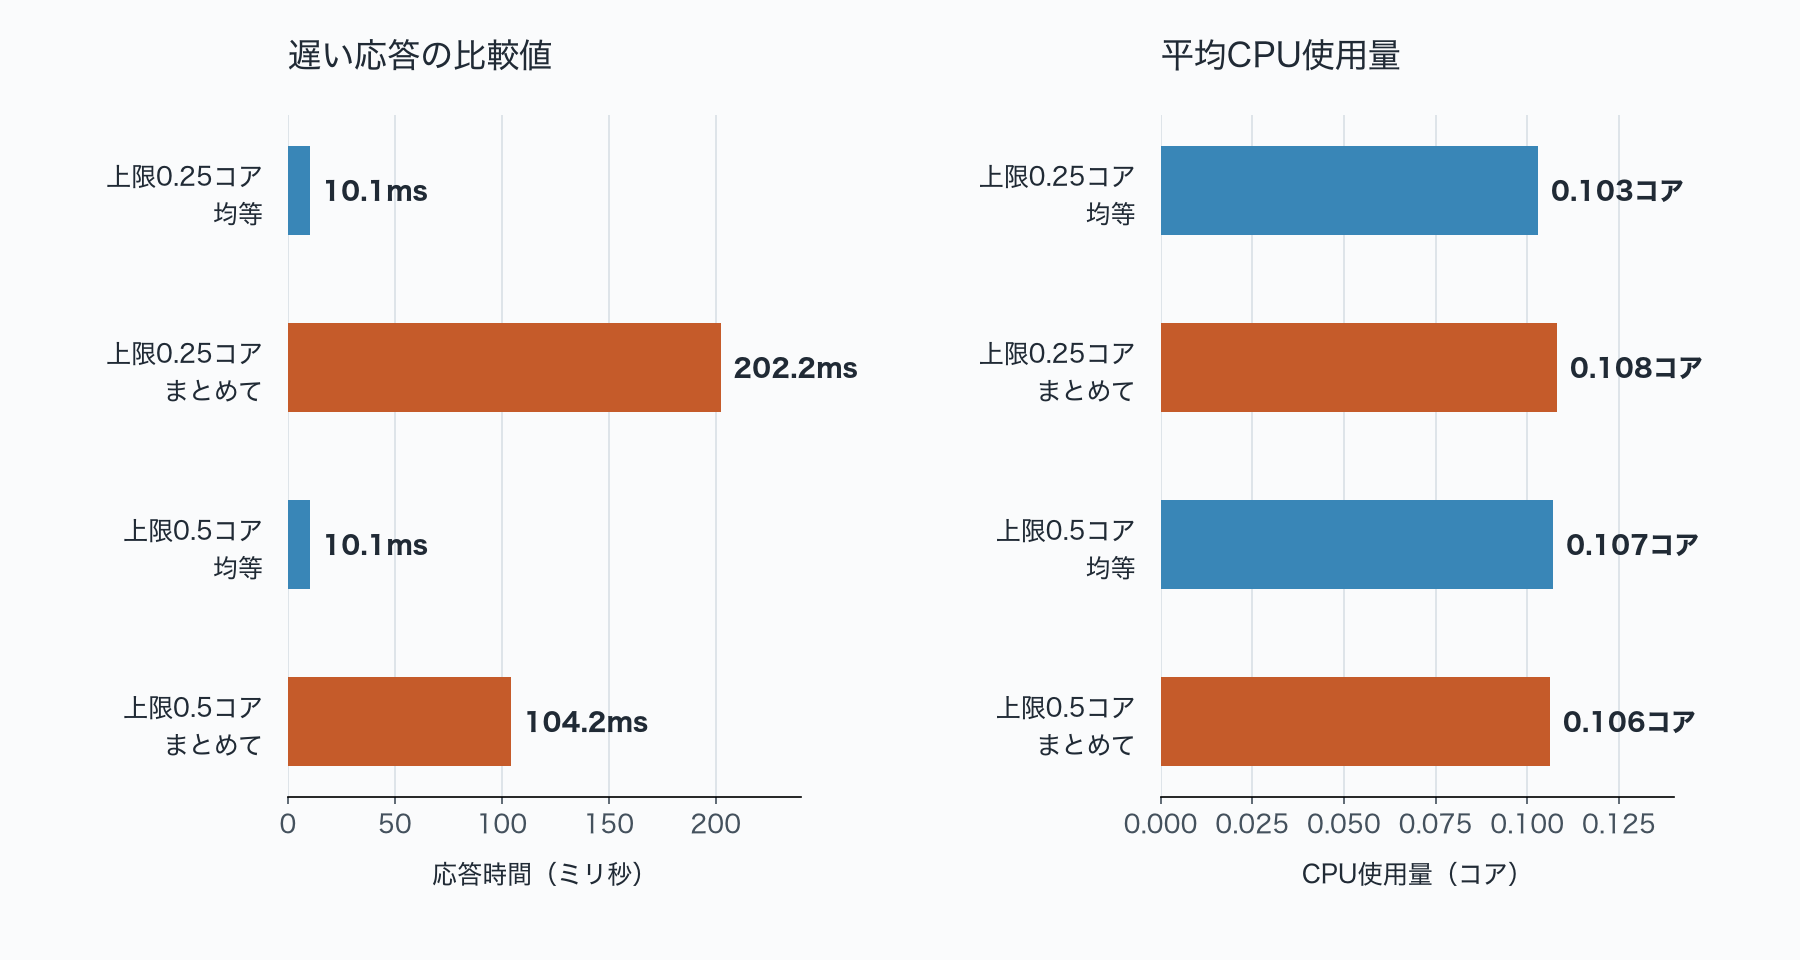
0.25コアの条件では、平均CPU使用量はどちらも上限の半分未満でした。それでも、まとめて送ったときの比較値は10.1msから202.2msへ、約20倍になりました。
次に、送り方はそのままでCPU上限を0.5コアに増やすと、まとめ送りの比較値は104.2msまで短くなりました。一方、均等に送る場合は約10msのままです。今回の条件では、CPU上限を増やした効果は、アクセスが集中する場合に表れました。
3回の測定で、まとめ送りの比較値は0.25コアで144.3〜203.4ms、0.5コアで69.8〜105.9msでした。毎回同じ値になるわけではありませんが、3回とも、まとめ送りのほうが遅いという傾向は変わりませんでした。
なぜ、平均では余っているCPUを使えないのか
今回のLinuxのCPU制限は、「CPUを常に4分の1の速度で動かす」という仕組みではありません。短い期間ごとに、使ってよいCPU時間を決める仕組みです。
0.25コアの条件で読み取った設定は、cpu.maxというファイルの25000 100000でした。単位はマイクロ秒なので、100ミリ秒の期間ごとに、合計25ミリ秒のCPU時間を使える設定です。対象アプリをまとめたグループ全体に適用され、1件ごとに25ミリ秒がもらえるわけではありません。Linuxカーネルの公式資料に、この設定形式と制限の記録が説明されています。
=約32ミリ秒のCPU時間が必要
アプリのCPU制限がかかることがある
1件約4ミリ秒の計算も、8件なら合計約32ミリ秒です。HTTPの処理なども加わるため、短い期間に仕事が集まると、使えるCPU時間を使い切ることがあります。
一方、約20秒間の平均には、リクエストが来ない時間も入ります。長く平均すると余裕があっても、集中した瞬間にはCPUの制限にかかり得る。これが、平均値だけでは見えない点でした。
実際にCPUの制限がかかった記録も確認した
説明だけで決めつけず、Linuxが残す記録も調べました。cpu.statというファイルのnr_throttledには、CPU時間の予算を使い切って制限された周期の数が記録されます。各測定の前後で値を読み、増えた分を3回分合計しました。
| CPU上限 | 送り方 | 制限が発生した周期数 |
|---|---|---|
| 0.25コア | 均等 | 0 |
| 0.25コア | まとめて | 202 |
| 0.5コア | 均等 | 0 |
| 0.5コア | まとめて | 50 |
均等に送った条件では増加がなく、まとめて送った条件では、どちらの上限でも増えていました。つまり、平均CPU使用量が低くても、CPUの制限は実際に発生していました。
ただし、この記録だけでは、個々のリクエストが何ミリ秒待ったかまでは分かりません。今回のPythonサーバーには計算を同時に進められる量の制約もあり、処理の順番待ちや切り替えも遅さに関わります。上限なしの条件とも比べていないので、約20倍の差をすべてCPU制限だけのせいにはできません。
同じように遅くなったら、何を確認するか
最初の疑問だった「CPUには余裕があるのに、どこで待っているのか」に対して、今回分かったのは、CPUの平均使用量が低くても、アクセスが集中するとCPU制限がかかり、応答が遅くなる場合があるということです。平均のグラフだけでは、CPUの問題を候補から外せません。
自分のアプリで同じ状況に出会ったら、次の順で確認します。
- 遅かった時刻のアクセスを見る。 いつも見ている応答時間の記録やアクセスログで、遅い応答が出た時間帯を調べます。1分間の合計だけでなく、記録の時刻を見て、同じ秒やその一部にアクセスが重なっていないかを確かめます。粗い時刻しか残っていなければ、それより短い集中の有無は判断できません。
- その間に、CPU制限がかかった記録が増えたかを見る。 利用中の監視画面に「CPUスロットリング」の項目があれば、これがCPU制限による実行待ちを示す記録です。遅かった時間帯と照合します。Linuxでアプリの実行環境を確認できる場合は、そのアプリが属するグループの
cpu.statを前後で読み、nr_throttledの増分を確認できます。見つけられなければ、運用担当者に「この時間帯、アプリのCPU制限がかかっていたか」と聞くのでも構いません。 - 制限が重なっていたら、開発環境でCPU上限だけを変えて比べる。 アクセスの件数・集中の仕方・処理内容を揃え、応答時間と制限の記録がどう変わるかを見ます。今回も、上限を増やすとまとめ送りの応答は短くなりましたが、均等送信はほぼ変わりませんでした。自分のアプリでも効果を確認してから、上限を見直す判断につなげます。
CPU上限を増やしても改善しなければ、データベースへの問い合わせや外部通信など、ほかの待ち時間を調べます。また、制限の記録が増えていなくても、確認したグループが違ったり、上位のグループに別の制限があったりする可能性は残ります。
「CPUが余っているから関係ない」と終わらせず、遅かった時刻と、アクセスの集中、CPU制限の記録を並べて確かめる。今回の実験は、次に調べる場所を決めるために使えます。
測定条件と結果の読み方
応答時間は、送信予定時刻からレスポンス本文を読み終えるまでを測りました。送信プログラムが予定より遅れて動いた時間も含みます。その遅れについても全体の99%に当たる値を調べたところ、条件別に約1.1〜5.7ミリ秒でした。
送信時刻は前の応答を待たずに決めています。遅いときに送る件数まで減って、アクセスの集中が弱まるのを避けるためです。
- 環境:Linux、4論理CPU、cgroup v2。ほかの処理も動く共有マシン。
- サーバー:Python 3.11のThreadingHTTPServer。HTTP/1.1で接続を再利用し、TCP_NODELAYを有効化。
- 計算:1件につきSHA-256を5,025回。測定前の調整で、計算のCPU時間の中央値は約4.0ミリ秒。
- 送信:同じマシン内で最大8並列。50ミリ秒ごとに1件、または400ミリ秒ごとに8件。
- CPU上限:0.25/0.5コア、周期100ミリ秒。測定対象の上位グループからの追加のCPU帯域制限なし。
- 測定:各20秒を3回、順序を変更。サーバーは毎回起動し直し、準備運転の分は集計から除外。
- 応答時間の集計:各条件1,200件の短い順の1,188番目。各回の比較値は400件の396番目で、本文の範囲は3回の最小〜最大。
- CPU使用量の集計:
cpu.statのusage_usec増分を秒に直し、CPU観測秒数で割った値の3回平均。
CPU観測は送信予定開始の約0.1秒前から始まっているので、分母は約20.101秒です。CSVのduration_s(送信開始からの約20秒)とは異なります。観測秒数の逆算値と、別の時刻記録による近似値はruns.csvに収録しています。詳しくはデータの補足を参照してください。
今回のCPython 3.11には、複数スレッドでPythonコードを同時実行できる範囲を制約するGILという仕組みがあります。Python公式資料も参照してください。ほかの処理や実行順序の影響は分離しておらず、固定した計算回数でも実際のCPU時間は変動します。別のマシンやアプリで同じ時間や倍率になることを示す実験ではありません。
測定データと実験コード
再現用コードは、systemdのユーザーサービスでCPU制限を設定できるLinux環境向けです。
Webアプリの公開に
GitHubに置いたWebアプリを、日本リージョンで動かしたい方へ。KamuiDashでは、リポジトリからアプリをデプロイできます。